한 달에 1억 5천만 개의 웹훅,
우리는 어떻게 처리하고 있을까?
배준수
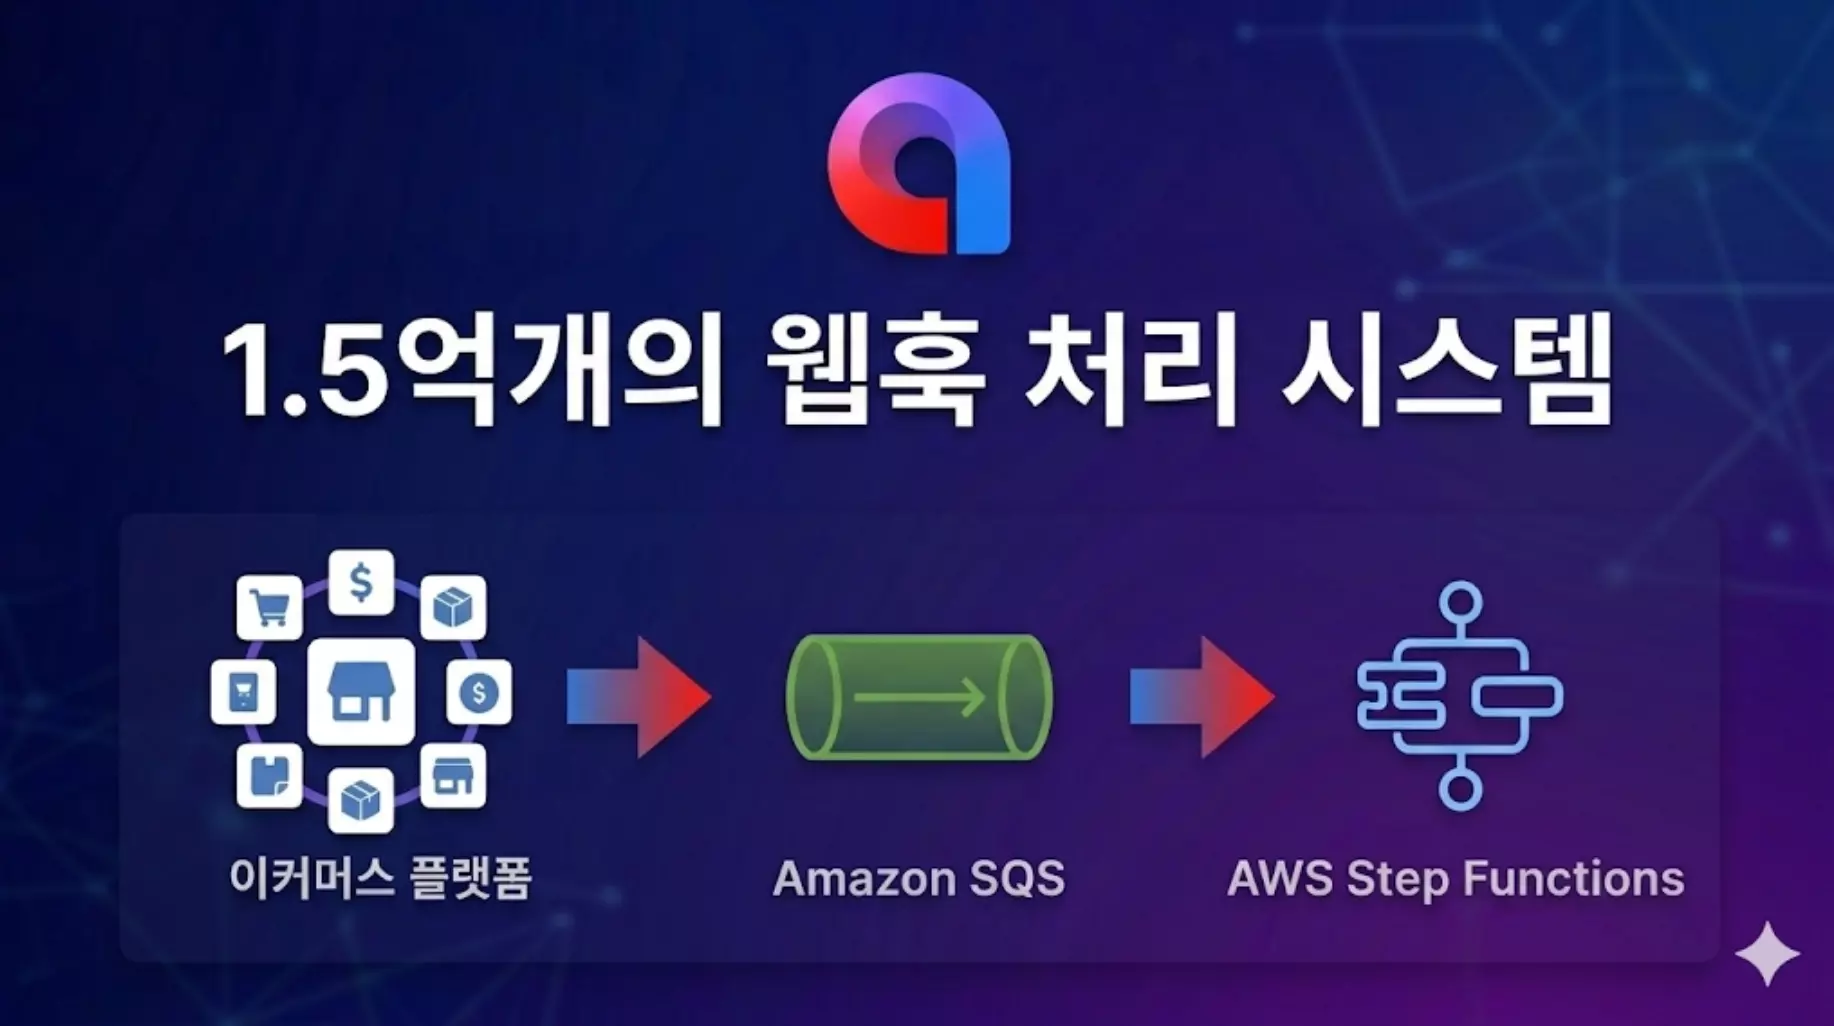
l 샐러드랩 코어 스쿼드가 웹훅 처리 시스템을 만들고 개선해온 여정을 공유합니다💡
들어가며
안녕하세요! 샐러드랩 코어스쿼드의 백엔드 개발자 배준수입니다.
저희는 카페24, 아임웹 같은 이커머스 플랫폼과 연동해서 쇼핑몰 데이터를 실시간으로 동기화하고 있는데요. 현재 한 달에 1억 5천만 개 이상의 웹훅을 처리하고 있습니다. 하루 평균 약 500만 개, 피크 타임에는 이보다 훨씬 더 많은 양이 한꺼번에 밀려들어오기도 하죠.
그런데 처음부터 이런 구조는 아니었어요. Cron 기반의 주기적 동기화에서 시작해서, 여러 문제를 겪으며 지금의 구조까지 발전해왔습니다.
이번 글에서는 그 여정을 처음부터 편하게 풀어보려고 합니다.
잠깐, 웹훅이 뭔가요?
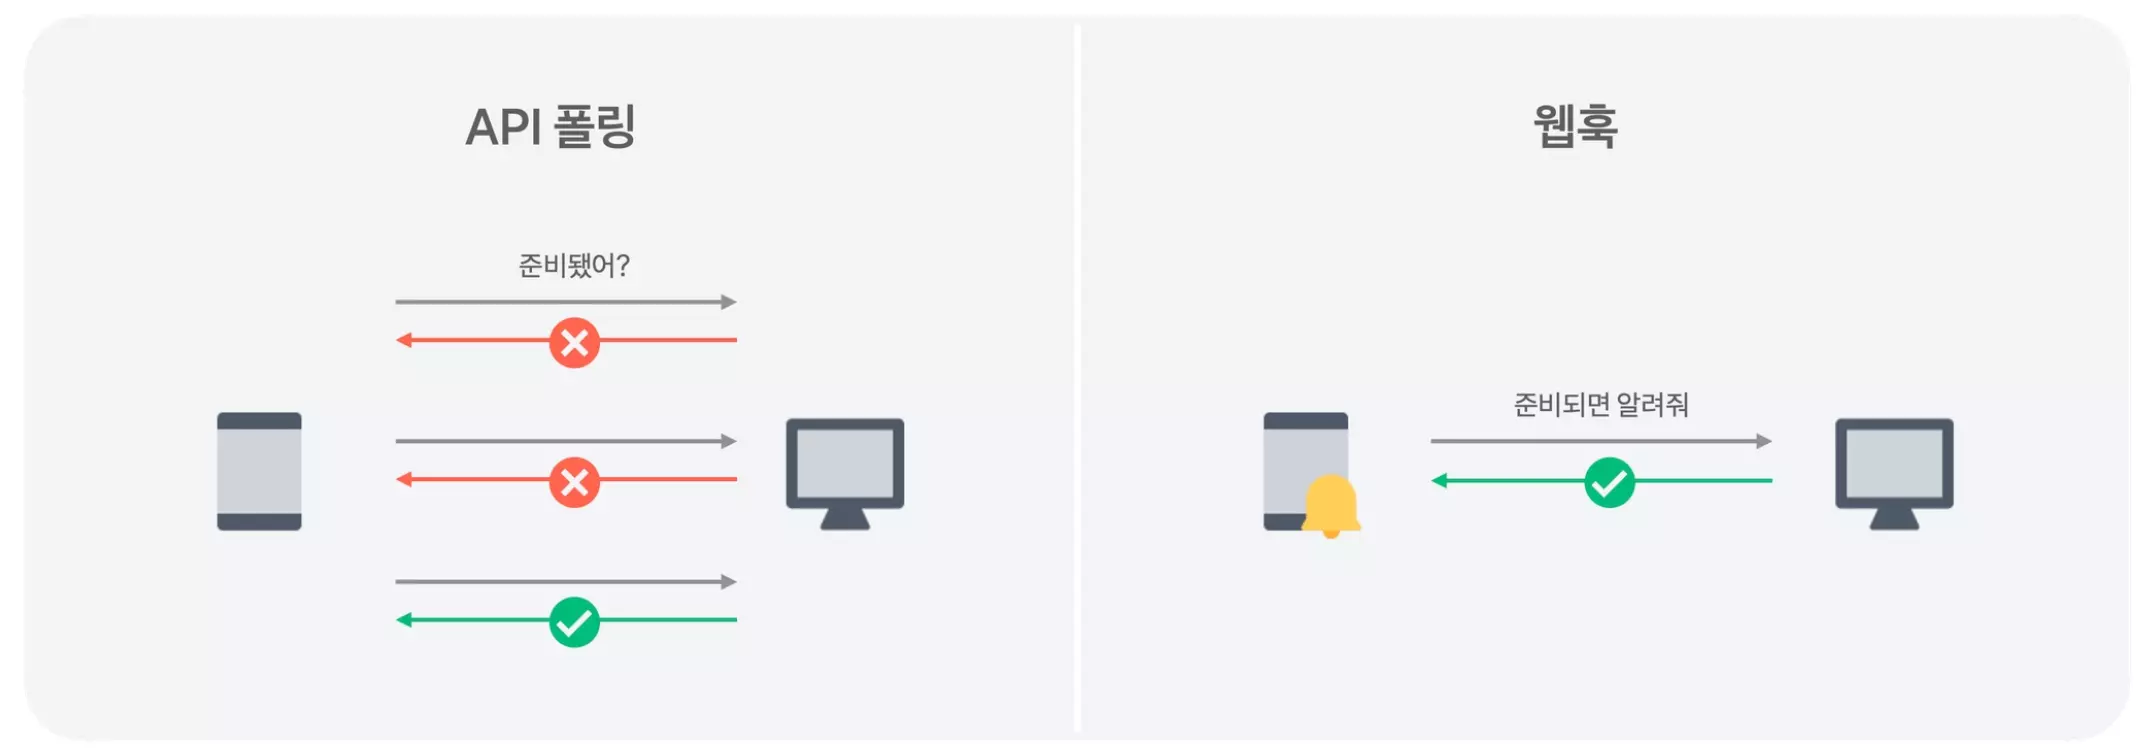
본론에 들어가기 전에 웹훅이 뭔지 간단히 짚고 갈게요.
보통 데이터가 바뀌었는지 확인하려면 주기적으로 “혹시 바뀐 거 있어?” 하고 물어봐야 하잖아요. 이걸 폴링(Polling) 이라고 합니다.
웹훅은 이와 반대예요. 데이터가 바뀐 쪽에서 먼저 알려주는 방식입니다.
쉽게 말하면 “야, 나 데이터 바뀌었어! 확인해봐!” 하고 알림을 보내주는 거라고 생각하시면 돼요.
저희 서비스 기준으로는 카페24에서 상품 가격이 바뀌면,
카페24가 알파앱스에게 “이 상품 데이터가 바뀌었으니 확인해!” 하고 HTTP 요청을 보내주는 거죠.
웹훅이 없다면?
웹훅이 왜 중요한지, 두 가지 상황으로 살펴볼게요.
상황 1: 가격이 달라요
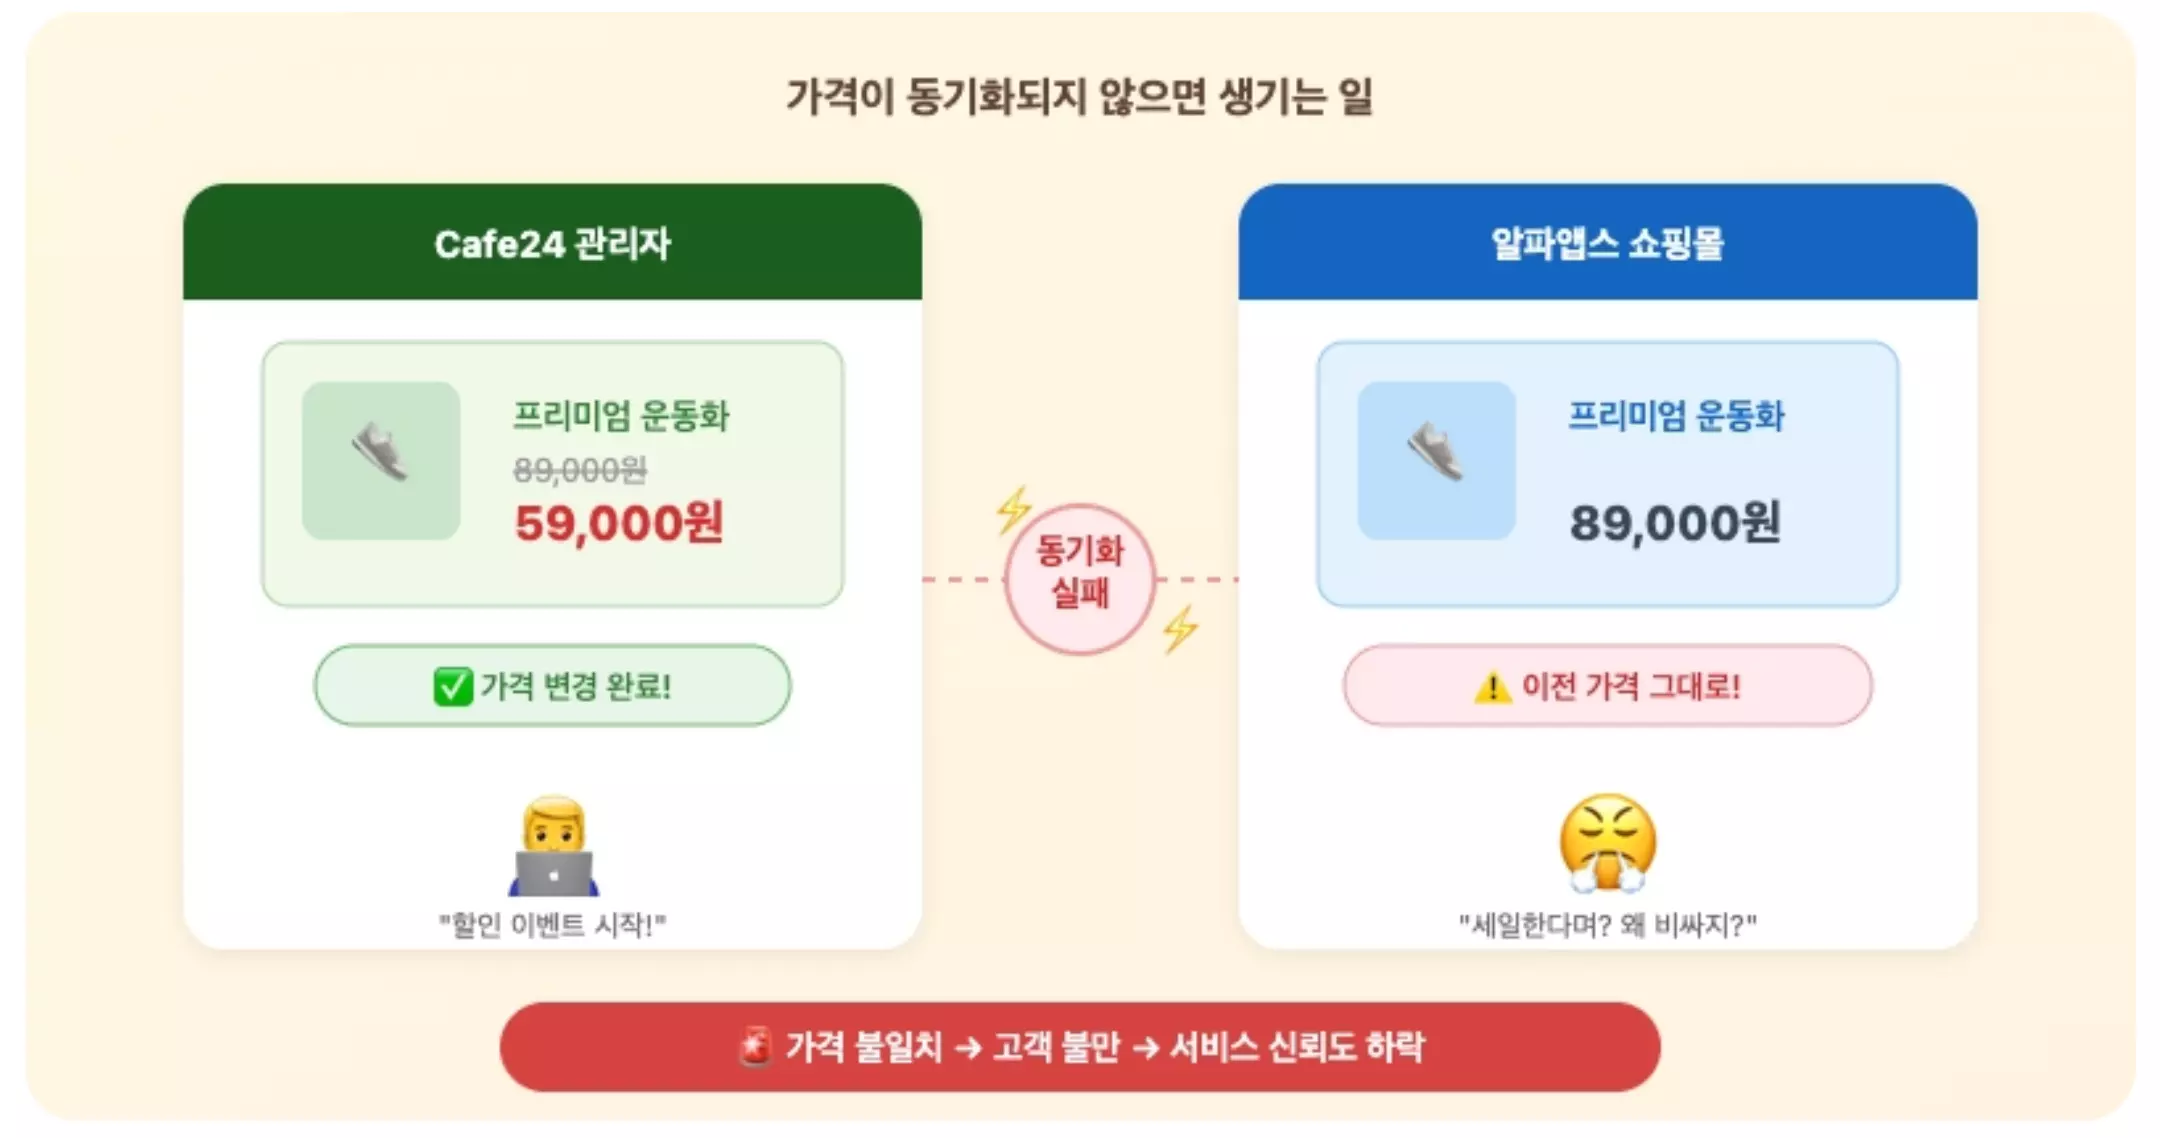
카페24에서 운동화를 89,000원에서 59,000원으로 할인했는데, 이 변경이 우리 DB에 반영되지 않았다면? 쇼핑몰에는 여전히 89,000원으로 표시됩니다. 할인 이벤트를 보고 온 고객은 “세일한다며? 왜 비싸지?” 하고 이탈하겠죠. 가격 불일치는 고객 불만과 직결되고, 서비스 신뢰도에 큰 타격을 줄 수 있어요.
상황 2: 상품이 안 보여요
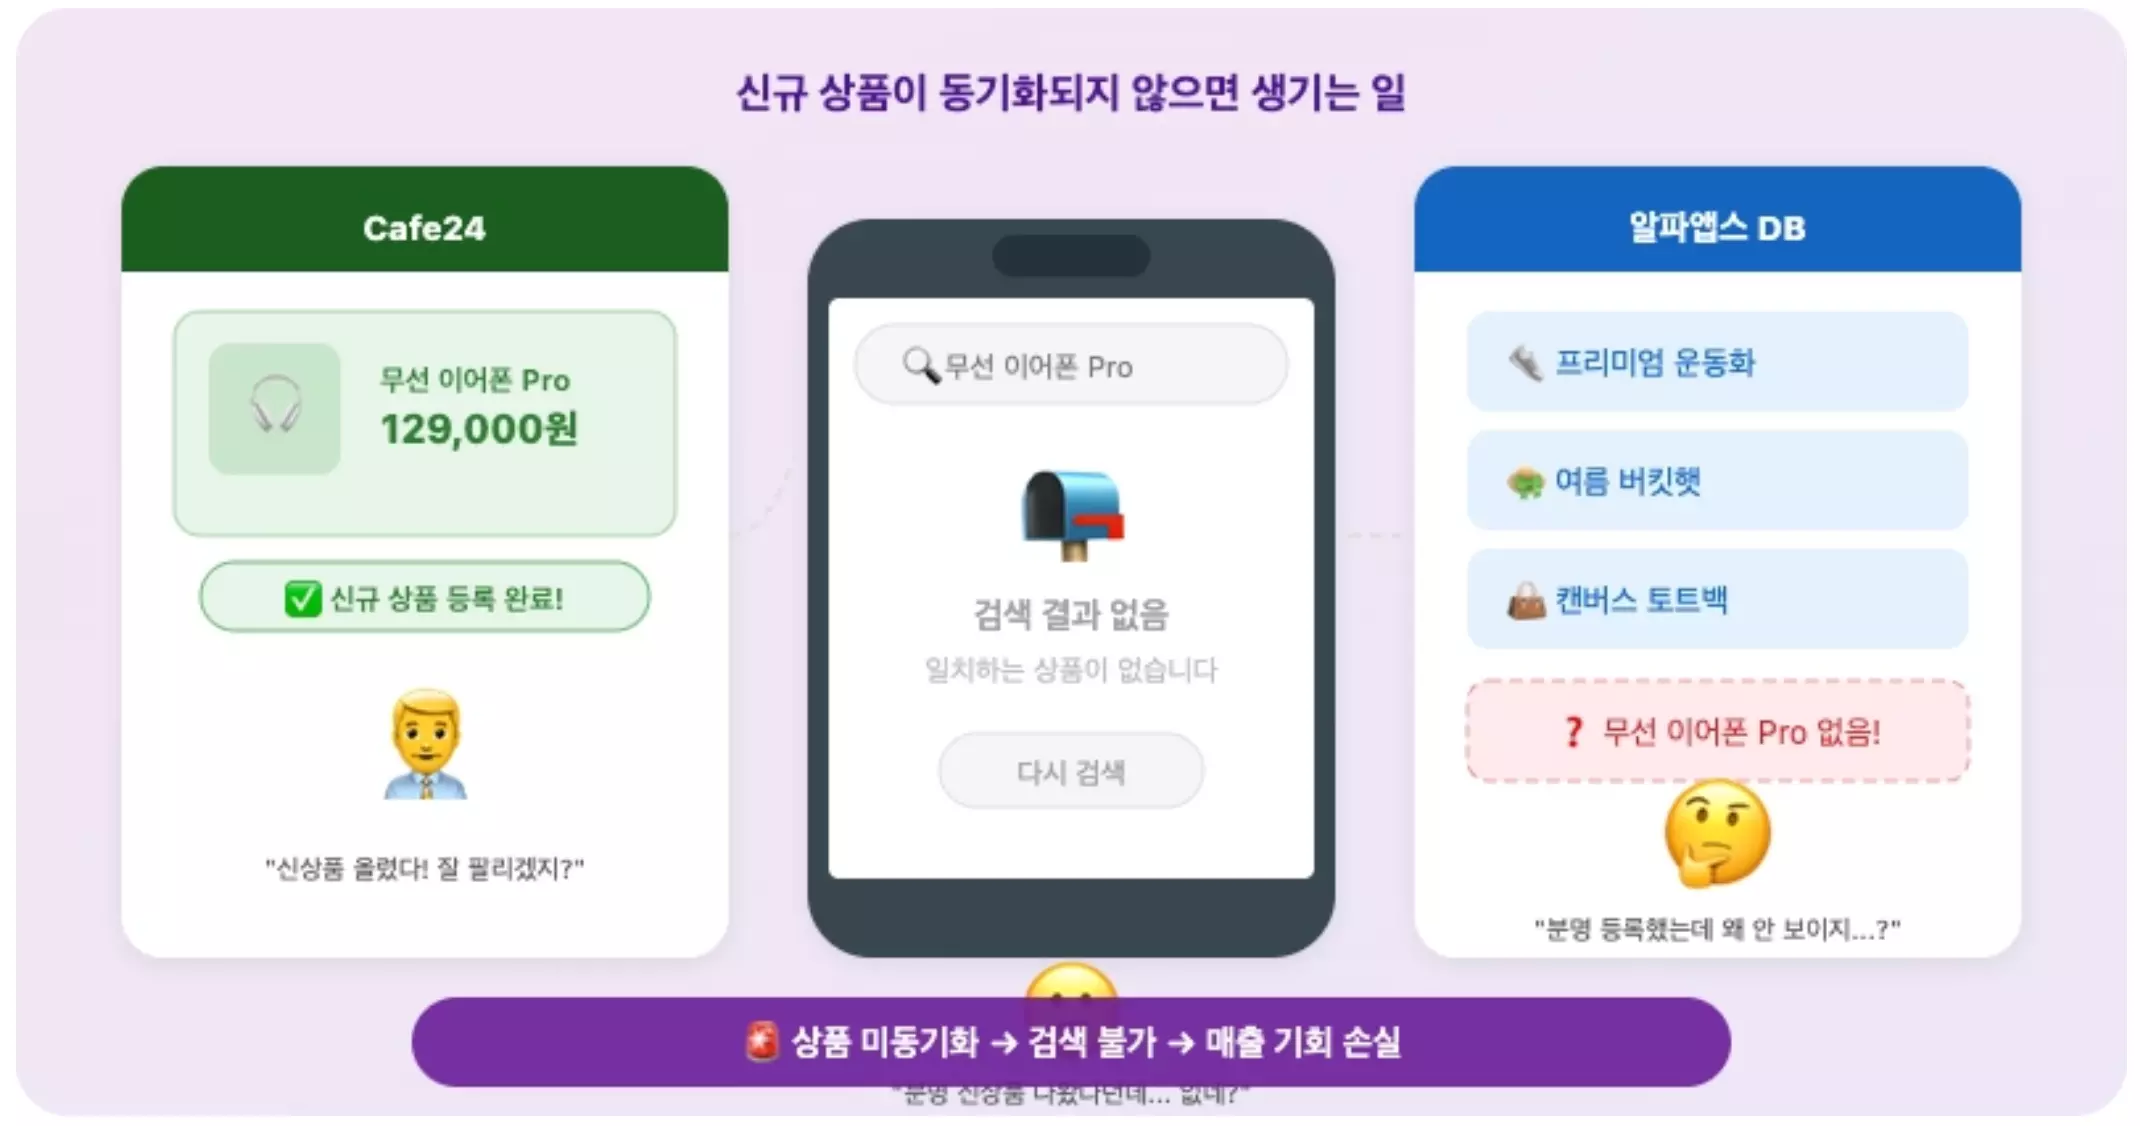
사장님이 카페24에 신상품 “무선 이어폰 Pro”를 등록했는데, 이 정보가 알파앱스 DB에 동기화되지 않았다면? 고객이 검색해도 상품이 나오지 않고, 사장님은 “분명 등록했는데 왜 안 보이지?”하며 고개를 갸우뚱하게 됩니다. 상품이 안 보이는 순간 매출 기회는 그대로 날아가버리는 거예요.
이처럼 데이터 변경을 실시간으로 감지하고 반영하는 것은 이커머스 서비스에서 정말 중요합니다. 웹훅이 바로 이 역할을 해주고 있어요.
1단계: 처음에는 이렇게 했어요 — Cron 기반 동기화
저희 서비스 초기에는 웹훅을 쓰지 않았어요. 대신 Cron 작업으로 주기적으로 데이터를 긁어오는 방식이었어요.
연동이 필요한 각 모델(상품, 주문 등)에 “마지막 업데이트 시점” 필드를 두고,
마지막 업데이트가 일정 기간 지난 업체를 대상으로 N시간마다 데이터 이관 작업을 돌리는 구조였어요.
이 방식에도 분명 장점이 있었습니다. 다음 주기에 어떤 데이터가 갱신될지 예측이 가능했고, 이전 갱신 시점도 정확하게 알 수 있었어요.
오랜 기간 운영되면서 안정성이 검증되기도 했고요.
그런데 문제가 하나둘 보이기 시작했어요
업체가 점점 많아지고, 특히 대형 업체가 늘어나면서 이관 작업이 무거워졌습니다. 실제로 알파리뷰의 주문 데이터 이관이 12시간 넘게 걸리기도 했어요.
문제를 정리하면 다음과 같습니다.
- 데이터 동기화 지연이 길었어요. 짧아도 15분, 길면 수 시간씩 걸리니까 쇼핑몰에 잘못된 정보가 표시될 가능성이 항상 있었어요.
- 한 업체가 전체에 영향을 줬어요. 변경사항이 많은 업체 하나 때문에 다른 모든 업체의 데이터 갱신도 밀리는 상황이 생겼습니다.
- 갱신 시점이 불투명했어요. 지연이 발생하면 데이터가 정확히 언제 반영될지 알 수가 없었어요. 서비스 종류가 늘어날수록 이건 큰 불안 요소였죠.
주기적 작업의 반복 주기를 줄이는 건 물리적으로 한계가 있었기에, 결국 카페24 웹훅을 활용하는 방향으로 전환하기로 결정했습니다.
2단계: 웹훅 도입 — EC2 프로세서 기반 구조
웹훅을 도입하면서 처음 만든 구조는 EC2 프로세서 기반이었어요. 흐름은 이러했습니다.
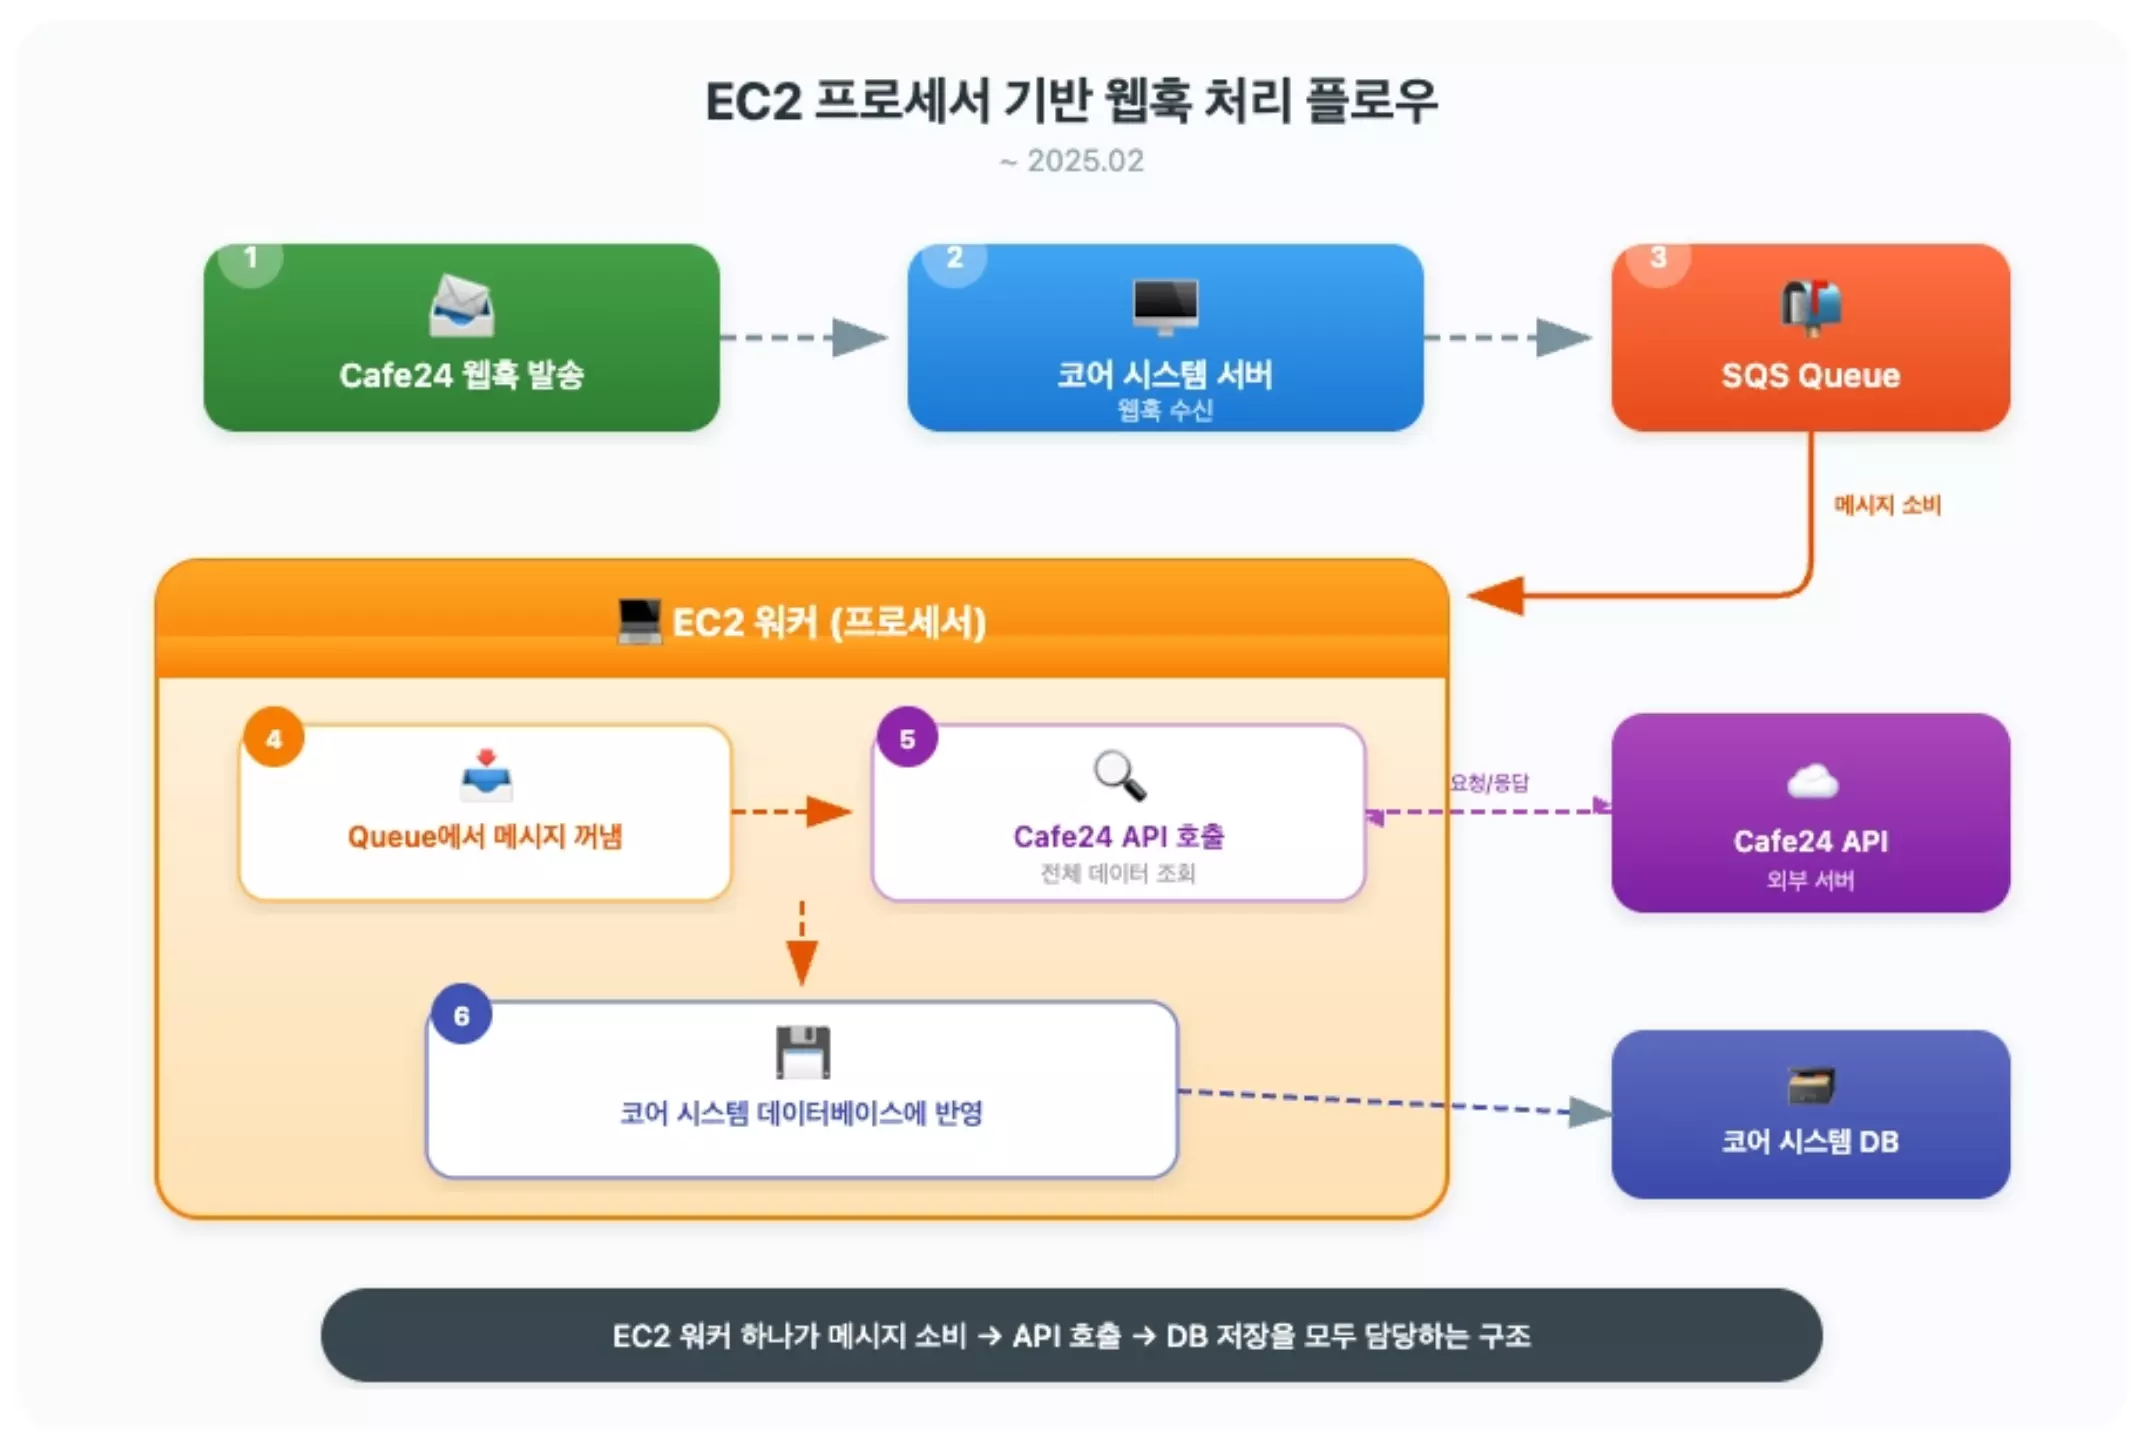
- 카페24에서 웹훅 발송
- 코어 시스템 서버에서 웹훅 수신
- 수신한 웹훅을 SQS Queue에 메시지로 삽입
- EC2 워커(프로세서) 가 Queue에서 메시지를 꺼냄
- 워커가 카페24 API를 호출해 전체 데이터 조회
- 조회한 데이터를 코어 시스템 데이터베이스에 반영
Cron 방식과 비교하면 확실히 개선됐어요. 데이터 변경이 발생하면 바로 알림을 받으니까 동기화 지연이 크게 줄었죠.
하지만 이것도 한계가 있었어요
EC2 워커가 Queue 소비부터 API 호출, DB 저장까지 전부 담당하다 보니, 처리 속도가 EC2 인스턴스의 성능에 완전히 의존했습니다.
웹훅이 늘어나면 EC2 사양을 올려야 했는데, 알파리뷰/업셀/푸시 등 모든 서비스의 웹훅을 하나의 EC2에서 처리하려다 보니 비용적으로 비효율적이었어요.
게다가 하나의 워커가 무거운 웹훅을 처리하느라 바쁘면, 뒤에 대기 중인 다른 쇼핑몰의 웹훅도 덩달아 지연되는 문제가 있었습니다.
3단계: Step Functions로 개선하다
2025년 2월, 근본적인 구조 개선을 단행했습니다. AWS Step Functions 기반으로 전환하게 되었죠.
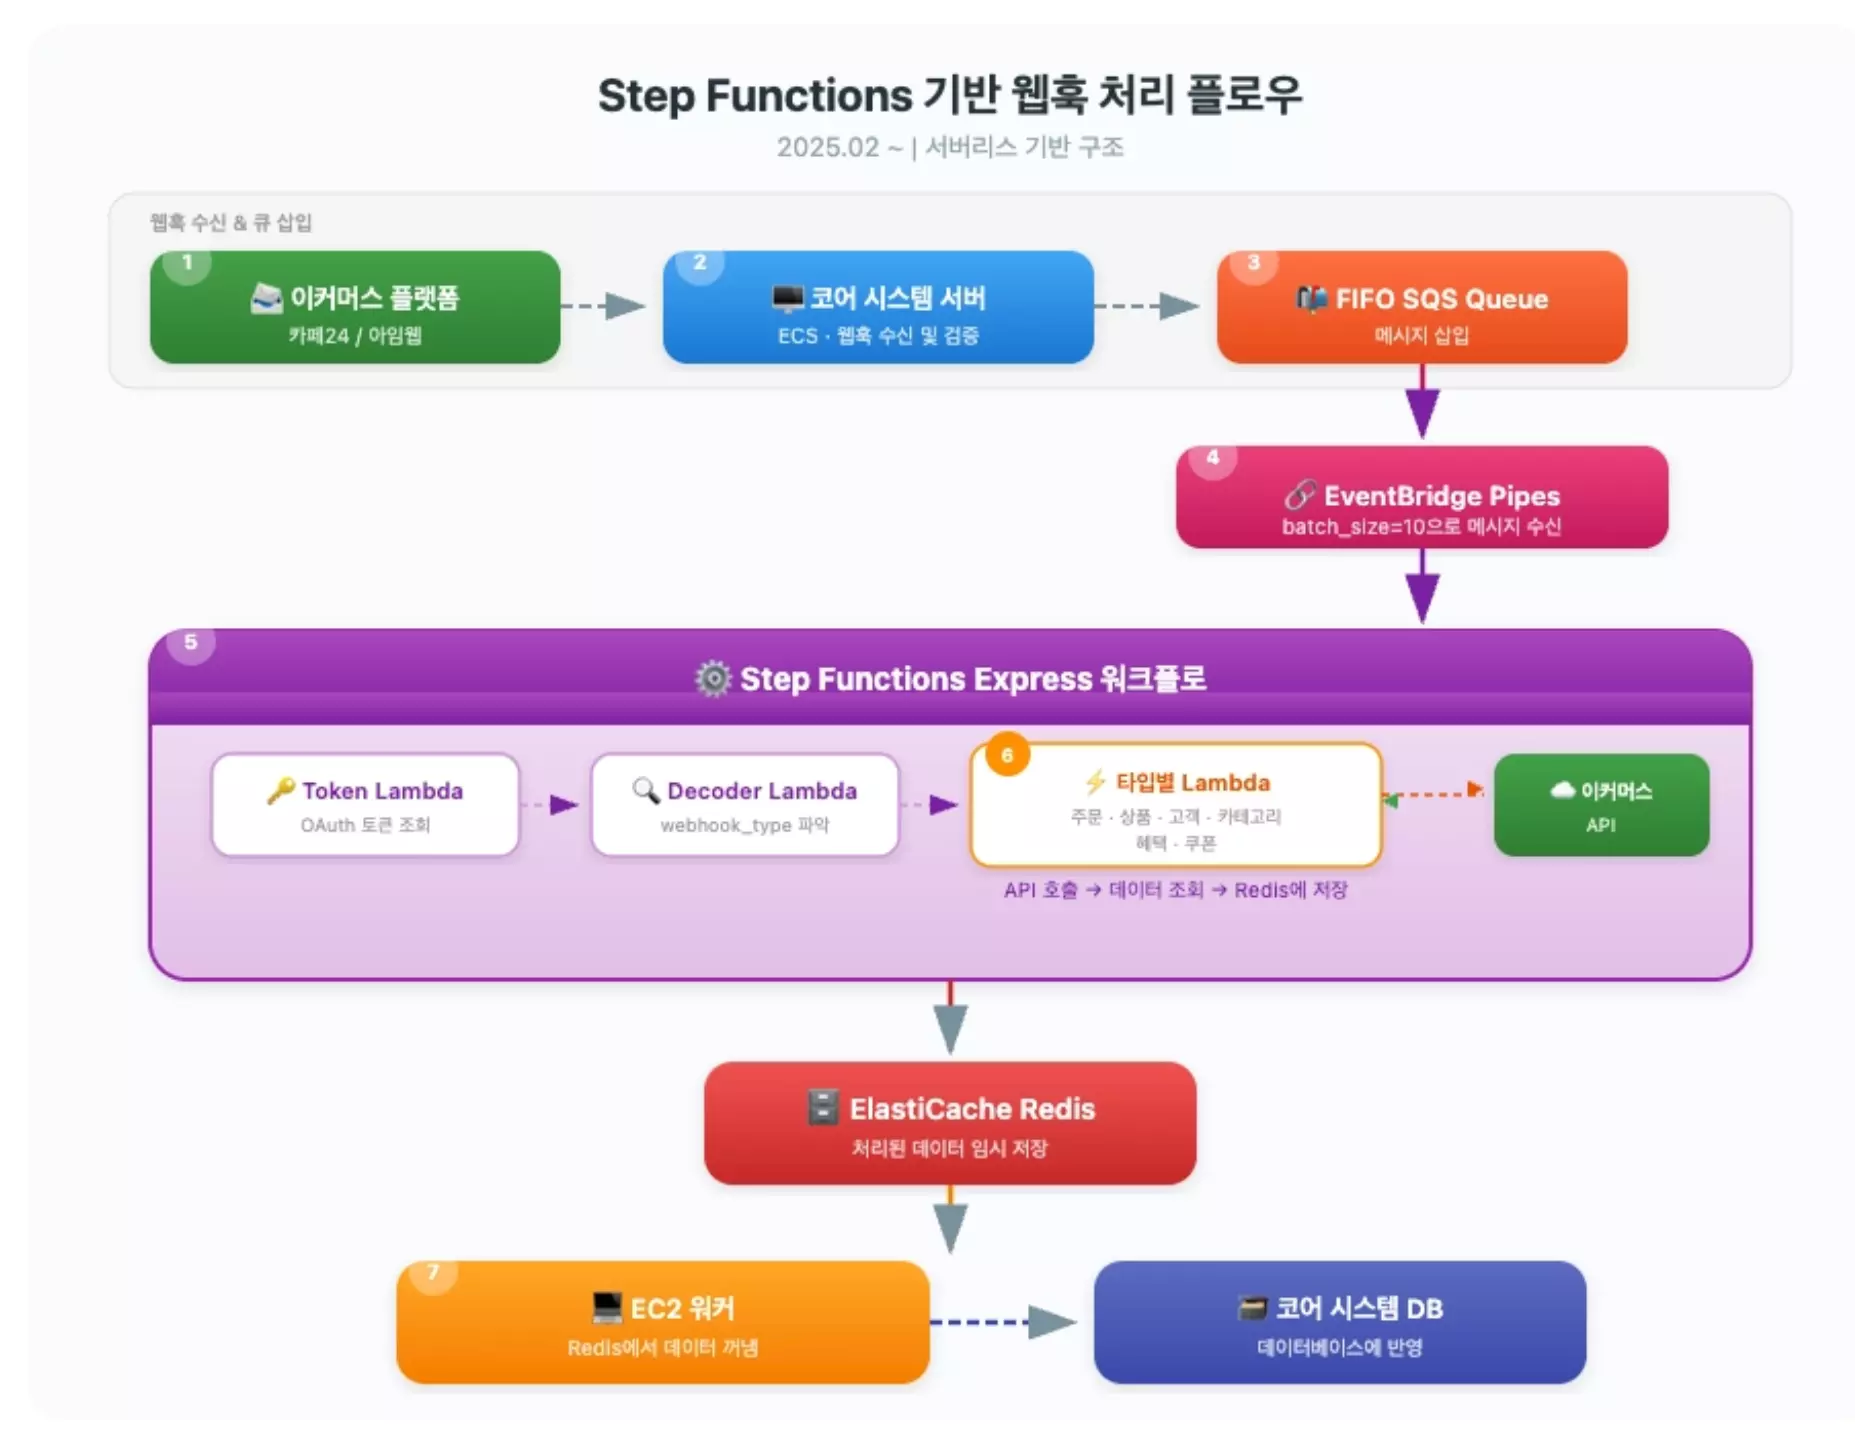
현재 구조의 흐름은 이렇습니다.
- 이커머스 플랫폼(카페24/아임웹)에서 웹훅 발송
- 코어 시스템 서버(ECS)에서 웹훅 수신 및 검증
- FIFO SQS Queue에 메시지 삽입
- EventBridge Pipes가 Queue에서 메시지를 가져옴
- Step Functions Express 워크플로 실행
- 웹훅 타입별 Lambda 함수가 이커머스 API를 호출해서 데이터 조회 및 redis 추가
- EC2 워커(프로세서)가 Redis에서 데이터를 꺼내 코어 시스템 데이터베이스에 반영
핵심 변화는 소비자(Consumer)가 EC2에서 Step Functions로 바뀐 것입니다.
비유하자면 거대한 컴퓨터 한 대가 모든 걸 처리하던 방식에서, 초소형 컴퓨터가 메시지마다 켜졌다 꺼지는 방식으로 바뀐 거예요.
이 변화로 얻은 장점은 두 가지입니다.
각 메시지가 독립적으로 처리되어 서로 악영향을 끼치지 않고, 필요한 만큼만 컴퓨팅 리소스를 사용하니 경제적이기도 합니다.
순서 보장과 독립성 — FIFO 큐와 메시지 그룹
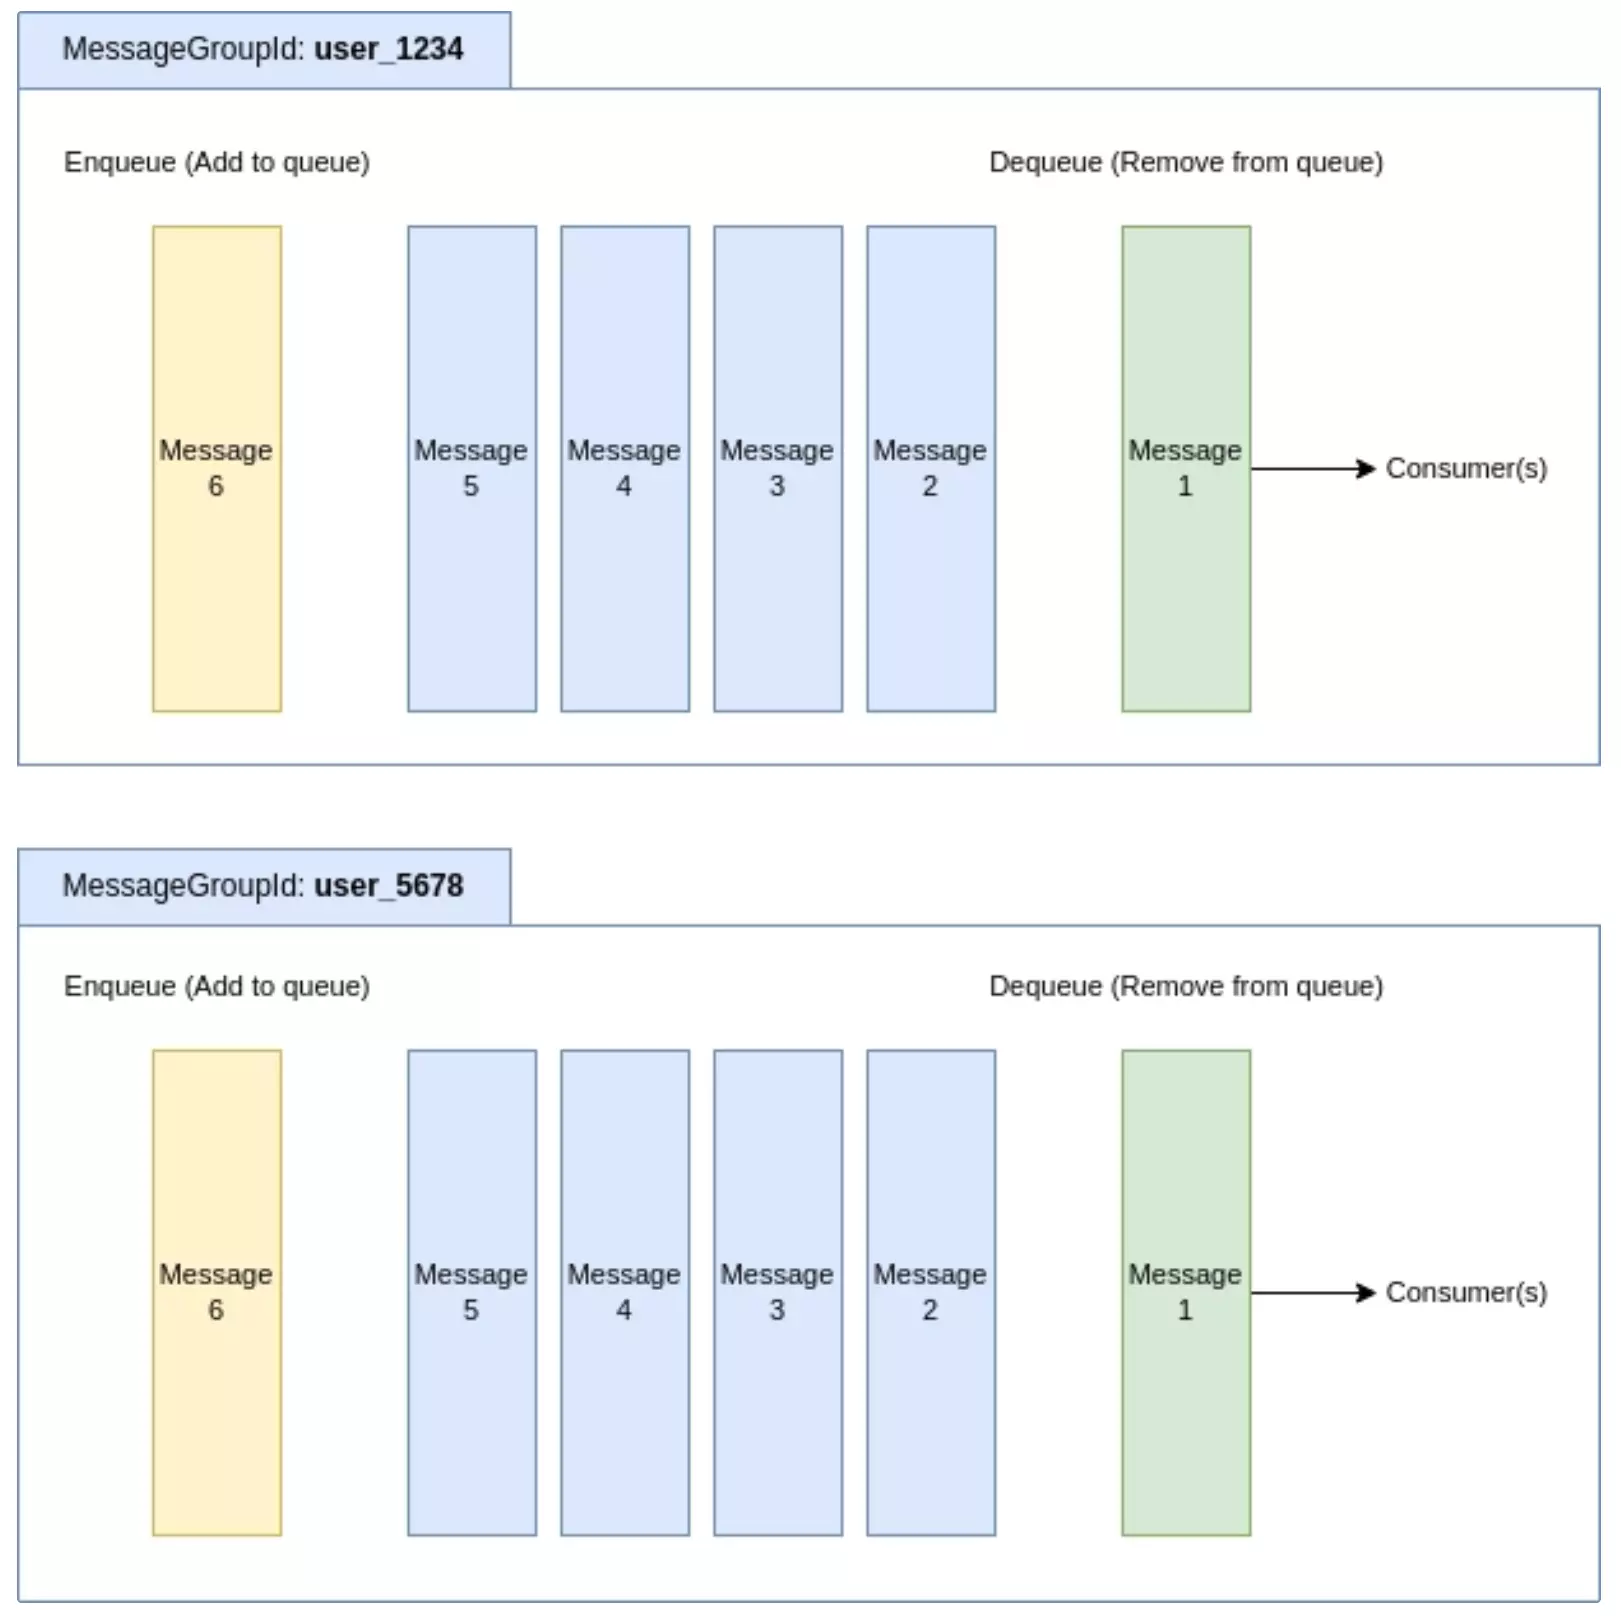
SQS FIFO 큐를 사용하면서, 메시지 그룹을 쇼핑몰별로 설정했습니다.
예를 들어 “A쇼핑몰”, “B쇼핑몰”처럼 나누는 거죠. 이렇게 하면 각 그룹 안에서는 선입선출이 보장됩니다.
상품 생성 웹훅보다 주문 웹훅이 먼저 처리돼서 존재하지 않는 상품에 대한 주문이 생기는 일이 없도록 하는 거예요.
실패에 대한 대비 — 3단계 큐 아키텍처
실패한 메시지를 놓치지 않기 위해 3단계 큐 구조를 설계했어요.
FIFO Queue, 그리고 DLQ(Dead Letter Queue)를 거쳐 최종 DLQ까지. FIFO Queue에서 처리에 실패한 메시지는 DLQ에서 재시도되고, 끝까지 실패하면 최종 DLQ에 쌓여 수동으로 확인할 수 있도록 했어요. 모든 큐는 14일간 메시지가 보존되고 암호화가 적용되어 있습니다. FIFO Queue에선 해당 메시지 그룹의 처리 지연을 막기 위해 재시도 로직을 넣지 않았어요.
개선 과정에서 겪은 이슈들
구조 전환이 한 번에 매끄럽게 된 건 아니에요. 몇 가지 시행착오가 있었습니다.
batch_size 조정: 처음에는 메시지를 하나씩 가져왔는데, batch_size를 10으로 늘려서 처리 속도를 개선했어요.
MapState 추가: eventbirdge pipe의 batch_size를 늘리고 보니, 한 배치 안에 서로 다른 메시지 그룹의 메시지가 섞여 들어오는 문제가 있었어요. 그래서 Step Functions에 MapState를 추가해서 각 메시지의 분기 처리가 독립적으로 이루어지도록 수정했습니다.
그래도 아직 남은 과제
Step Functions 전환으로 많은 부분이 개선되었지만, 데이터 저장 단계에는 여전히 병목이 존재합니다.
Step Functions의 Lambda가 처리한 데이터는 shop의 특정 값 범위를 기준으로 Redis 리스트에 나뉘어 저장되고, EC2가 이 리스트에서 데이터를 꺼내 DB에 반영하는 구조인데요. 예를 들어 A는 하나의 리스트, B는 또 다른 리스트로 나뉘는 식이에요.
문제는 A 리스트에 있는 한 쇼핑몰에서 웹훅이 대량 발생하면, 같은 A 리스트를 공유하는 쇼핑몰들의 저장이 함께 지연된다는 점입니다. 또한 쇼핑몰 수가 늘어날수록 리스트를 추가로 분기해야 하고, EC2 태스크 수도 늘려야 해서 확장성 면에서 아쉬운 부분이에요. 이 문제는 5단계에서 다루는 “Lambda에서 직접 DB 저장” 개선으로 해결할 계획입니다.
4단계: 폭주 대응 — 블랙리스트 시스템
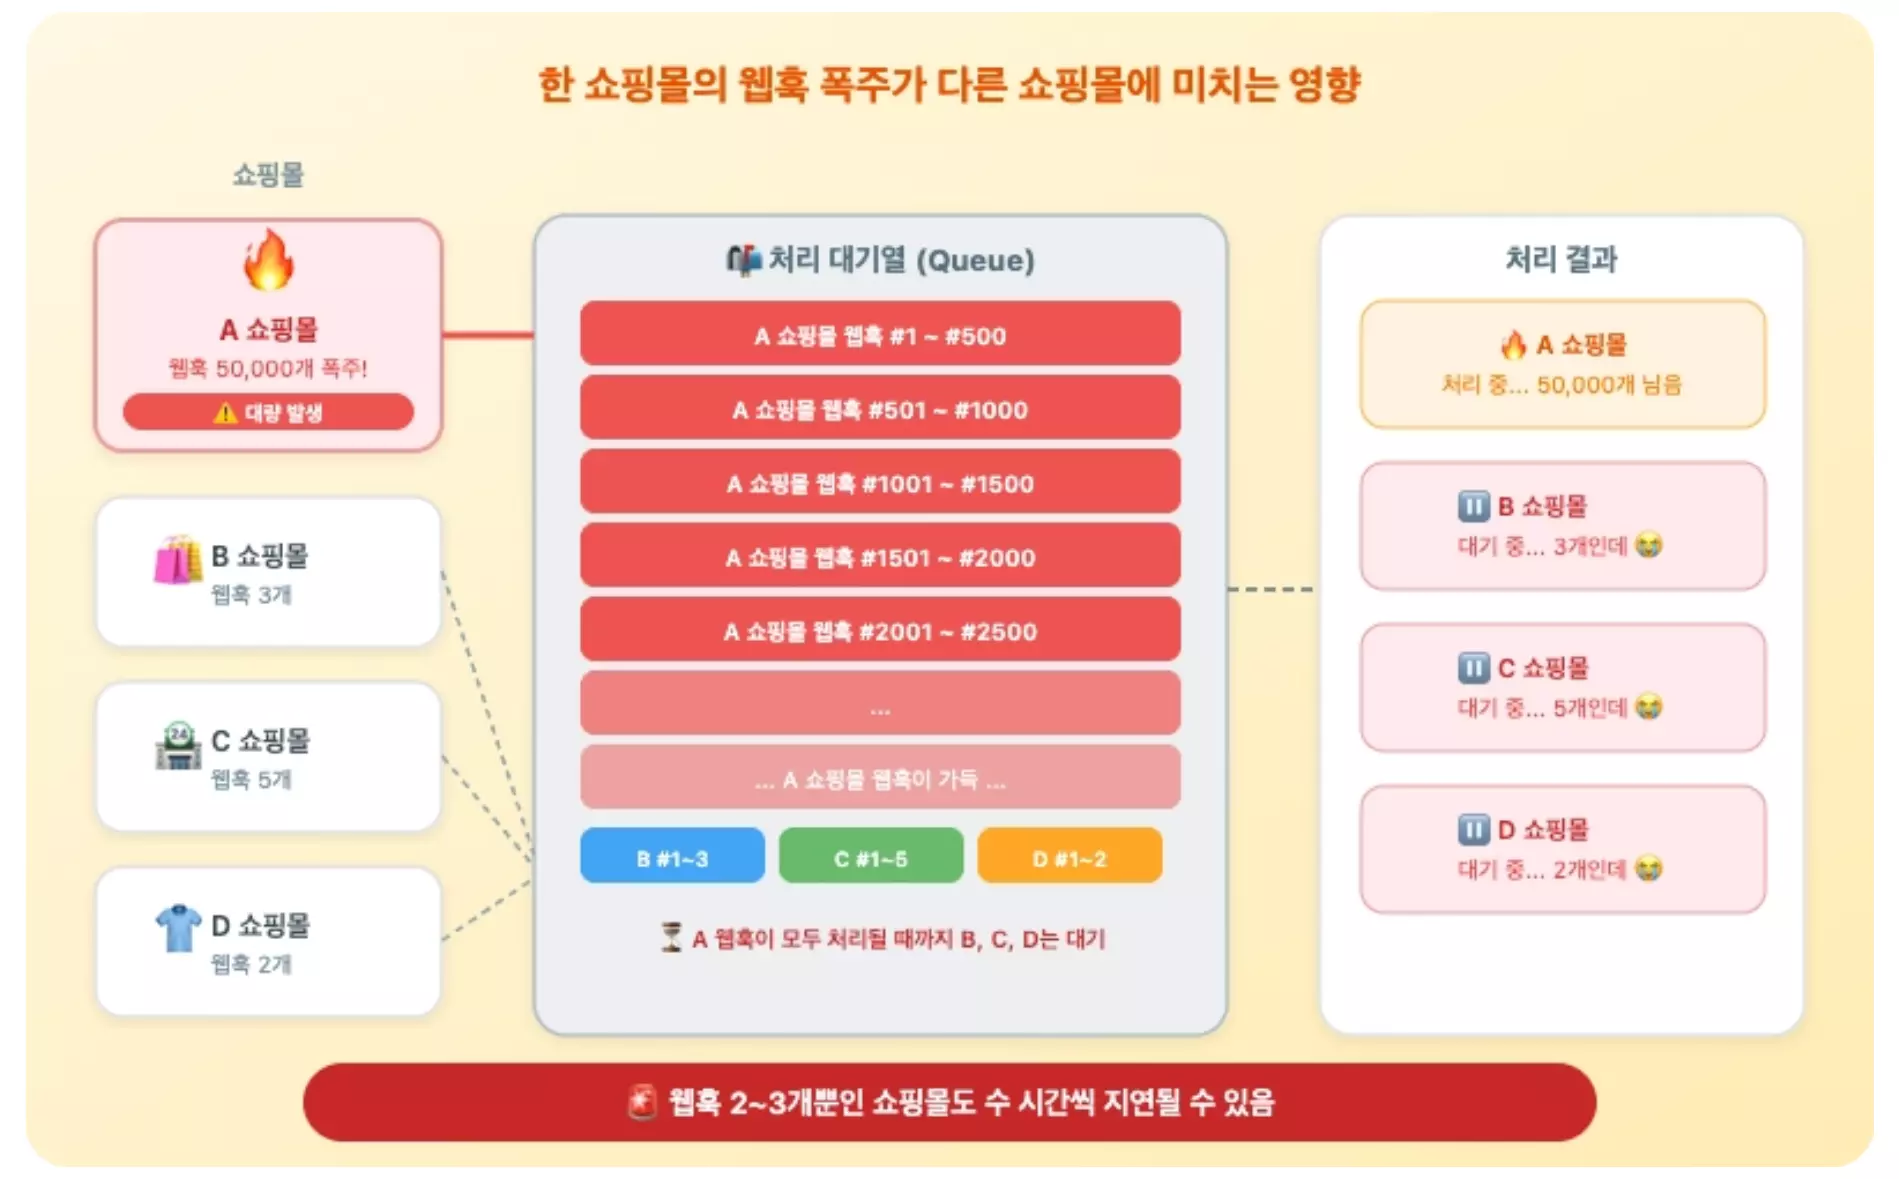
구조 개선과 별개로, 하나 더 풀어야 할 문제가 있었어요. 바로 웹훅 폭주입니다.
가끔 내부 프로그램 등을 이용해서 하루에 수만~수십만 개의 웹훅을 한꺼번에 보내는 쇼핑몰이 있거든요.
이런 쇼핑몰 하나 때문에 다른 쇼핑몰의 처리가 지연되면 안 되잖아요.
잠깐, FIFO 큐의 메시지 그룹으로 독립성이 보장되는 거 아닌가요?
좋은 질문이에요. 앞에서 FIFO 큐의 메시지 그룹을 통해 쇼핑몰 간 독립성을 보장한다고 설명했는데, 그렇다면 폭주 대응이 왜 따로 필요할까요?
문제는 EventBridge Pipes가 큐에서 메시지를 가져올 때 사용하는 receive_messages 메서드의 동작 방식에 있습니다.
이 메서드는 큐에서 수명이 가장 오래된 메시지부터 설정한 개수만큼 꺼내오는데, 이때 메시지 그룹을 구분하지 않아요.
그래서 한 쇼핑몰이 순간적으로 수만 개의 웹훅을 쏟아부으면, 큐에 그 쇼핑몰의 메시지가 가득 차게 됩니다. Pipe가 메시지를 꺼낼 때마다 이 메시지 뭉치가 먼저 나오게 되고, 이 뭉치가 모두 소비되기 전까지 그 뒤에 들어온 다른 쇼핑몰의 메시지는 처리되지 않는 거예요. 메시지 그룹이 논리적으로는 분리되어 있지만, 물리적으로 메시지를 꺼내는 단계에서는 완벽한 독립성이 보장되지 않는 셈이죠.
결국 폭주하는 쇼핑몰의 메시지가 큐에 쌓이는 것 자체를 막아야 했고, 그래서 블랙리스트 시스템이 필요했습니다.
그래서 2025년 5월에 유동적 블랙리스트 시스템을 도입했습니다.
어떻게 동작하나요?
모든 웹훅 수신 내역은 Redis의 Sorted Set에 기록됩니다. 키는 업체_쇼핑몰_이벤트타입 조합이고, 각 웹훅마다 UUID와 타임스탬프가 저장돼요.
3시간마다 크론 작업이 돌면서 각 조합의 웹훅 수를 체크합니다. 이때 역치를 넘긴 조합은 블랙리스트에 등록되는데요, 역치는 카테고리별로 다릅니다.
블랙리스트에 올라가면 해당 이벤트 타입의 웹훅만 차단되고, 나머지 이벤트 타입은 정상 처리됩니다. 예를 들어 상품 웹훅이 폭주해서 차단되더라도 주문 웹훅은 멀쩡하게 돌아가는 거죠. 이를 부분 차단 방식이라고 부르고 있어요.
그러면 차단된 데이터는 어떻게 되나요?
매일 밤 10시, 블랙리스트 대상 업체들에 대해 마이그레이션(일괄 동기화)이 진행됩니다.
이때 블랙리스트 해제 여부도 함께 확인해요. 역치 미만으로 떨어진 이벤트 타입은 블랙리스트에서 해제되고, 모든 이벤트 타입이 해제되면 다시 정상 상태로 돌아갑니다. 마이그레이션은 ThreadPoolExecutor로 최대 6개 스레드를 사용해서 병렬로 처리합니다.
고객 관련 이벤트는 좀 특별하게 처리해요. 블랙리스트 상태에서 들어온 고객 웹훅의 ID를 별도 Redis Set에 저장해두고, 마이그레이션 시 해당 고객만 개별적으로 동기화합니다. 전체 고객 데이터를 다시 긁어오는 것보다 훨씬 효율적이죠.
5단계: 지금 진행 중인 개선들
현재 시스템도 잘 돌아가고 있지만, 더 나아지기 위해 2026년 3월부터 몇 가지 개선을 진행하고 있어요.
웹훅 수신부의 서버리스 분리
현재 웹훅 수신을 메인 서버(ECS)에서 담당하고 있어서, 웹훅이 과다하게 발생하면 서버 전체의 응답 시간이 느려지는 문제가 있습니다.
API Gateway와 Lambda를 활용해서 웹훅 수신부를 서버리스로 분리할 계획이에요.
이렇게 하면 웹훅 트래픽이 아무리 많아져도 메인 서버에는 영향이 없고, 수신부가 독립적으로 스케일링될 수 있습니다.
Lambda에서 직접 DB 저장 (EC2 의존 제거)
위에서 말씀드렸듯, 현재 구조에서 한 가지 아쉬운 점은 Lambda가 처리한 데이터를 Redis에 넣고 EC2가 꺼내서 DB에 저장하는 중간 단계가 있다는 거예요. 왜 이렇게 했냐면, 데이터 저장 로직을 한 곳에서만 관리하고 싶었기 때문입니다. Lambda와 EC2 양쪽에 저장 로직이 흩어져 있으면 유지보수도 어렵고 버그 가능성도 높아지니까요.
하지만 이 문제는 Lambda의 런타임을 ECR(Elastic Container Registry) 이미지로 구성하면 해결할 수 있어요. 서버에서 사용하는 것과 동일한 Docker 이미지를 Lambda에서도 사용하면, 코드를 한 곳에서 관리하면서도 Lambda에서 직접 DB에 저장하는 것이 가능해집니다.
이렇게 되면 Redis → EC2라는 중간 단계가 사라지면서 데이터 저장 병목도 자연스럽게 해결될 수 있어요.
마치며
Cron 기반 주기적 동기화에서 시작해서, EC2 프로세서 기반 웹훅 처리를 거쳐, Step Functions 기반 서버리스 구조까지. 저희 웹훅 시스템은 문제를 만나고, 고민하고, 개선하는 과정의 연속이었어요. 물론 아직 완벽하지는 않고, 서버리스 수신부 분리나 Lambda 직접 저장 같은 개선을 계속 진행하고 있습니다.
비슷한 대규모 이벤트 처리 시스템을 고민하고 계신 분들에게, 저희의 시행착오와 경험이 조금이나마 도움이 되었으면 좋겠습니다.