손가락 대신 AI를 움직인 한 달 — 231세션에서 배운 것
이욱창
들어가며
최근 사내 프로젝트에서 Claude Code PoC를 진행하면서, 키보드로 직접 코드를 치는 시간보다 AI와 대화하는 시간이 더 길어졌습니다.
우리 팀도 곧 Cursor에서 Claude Code 기반 에이전트 환경으로 전환합니다. 뭐가 달라지는 건지, 플랜 모드나 잘 쓰면 되는 거 아닌지 고민하시는 분들이 있을 텐데, 거창한 이야기 대신 한 달간 수백 개의 세션을 열고 닫으며 겪은 삽질기와 팁을 정리해 봤습니다.
2026년 2월, OpenAI는 Codex 에이전트만으로 백만 줄 규모의 프로덕션 코드를 만든 사례를 공개했습니다. 엔지니어 3명이 5개월간 약 1,500개의 PR을 머지했고, 수동으로 작성된 코드는 0줄이었습니다. 그러면 우리는 어떻게 일해야 할까요?
1. AI가 내 눈치를 보기 시작했다 — AI의 세 가지 고질병
처음에 답답했던 건, AI들이 눈치를 너무 본다는 점이었습니다.
틀린 방향으로 이거 이렇게 짜는 거 맞냐고 물어보면, 네, 맞을 수도 있습니다! 라며 성실하게 엉뚱한 코드를 짜줍니다.
왜 이런 일이 생기냐면, 크게 세 가지 원인이 있습니다.
맥락 고착 (Context Stickiness). 세션이 길어질수록 AI가 초반 전제에 묶입니다. 사과를 그리다가 바나나로 바꿔달라고 하면, 바나나를 그리긴 하는데 묘하게 사과 색깔이 남아있는 식입니다. 컨텍스트 윈도우가 200K로 커져도 이 문제는 사라지지 않고, 오히려 중간 정보를 놓치는 Lost in the Middle 현상이 심해집니다. 사람이랑 비슷하게 처음과 끝을 더 잘 기억합니다.
RLHF 동의 편향 (Sycophancy). 학습 과정(RLHF)에서 정답보다 ‘사용자에게 칭찬받는 답변’이 높은 점수를 받으면서 생긴 구조적 문제입니다. 2025년 GPT-4o 업데이트에서 이게 심각하게 불거져서 OpenAI가 공개 사과 후 롤백했습니다. 완벽한 코드냐고 물어보면, 버그를 발견해도 좋아 보인다며 맞장구를 칩니다.
컨텍스트 불안증 (Context Anxiety). Anthropic이 하네스 설계 가이드에서 직접 언급한 현상입니다. 대화가 길어져 컨텍스트 창이 차기 시작하면 작업을 대충 서둘러 마무리하려 합니다. 창이 꽉 차면 예전 대화를 자동으로 압축(Compaction)해 버리는데, 이때 중요한 논리적 배경들이 먼저 날아갑니다.
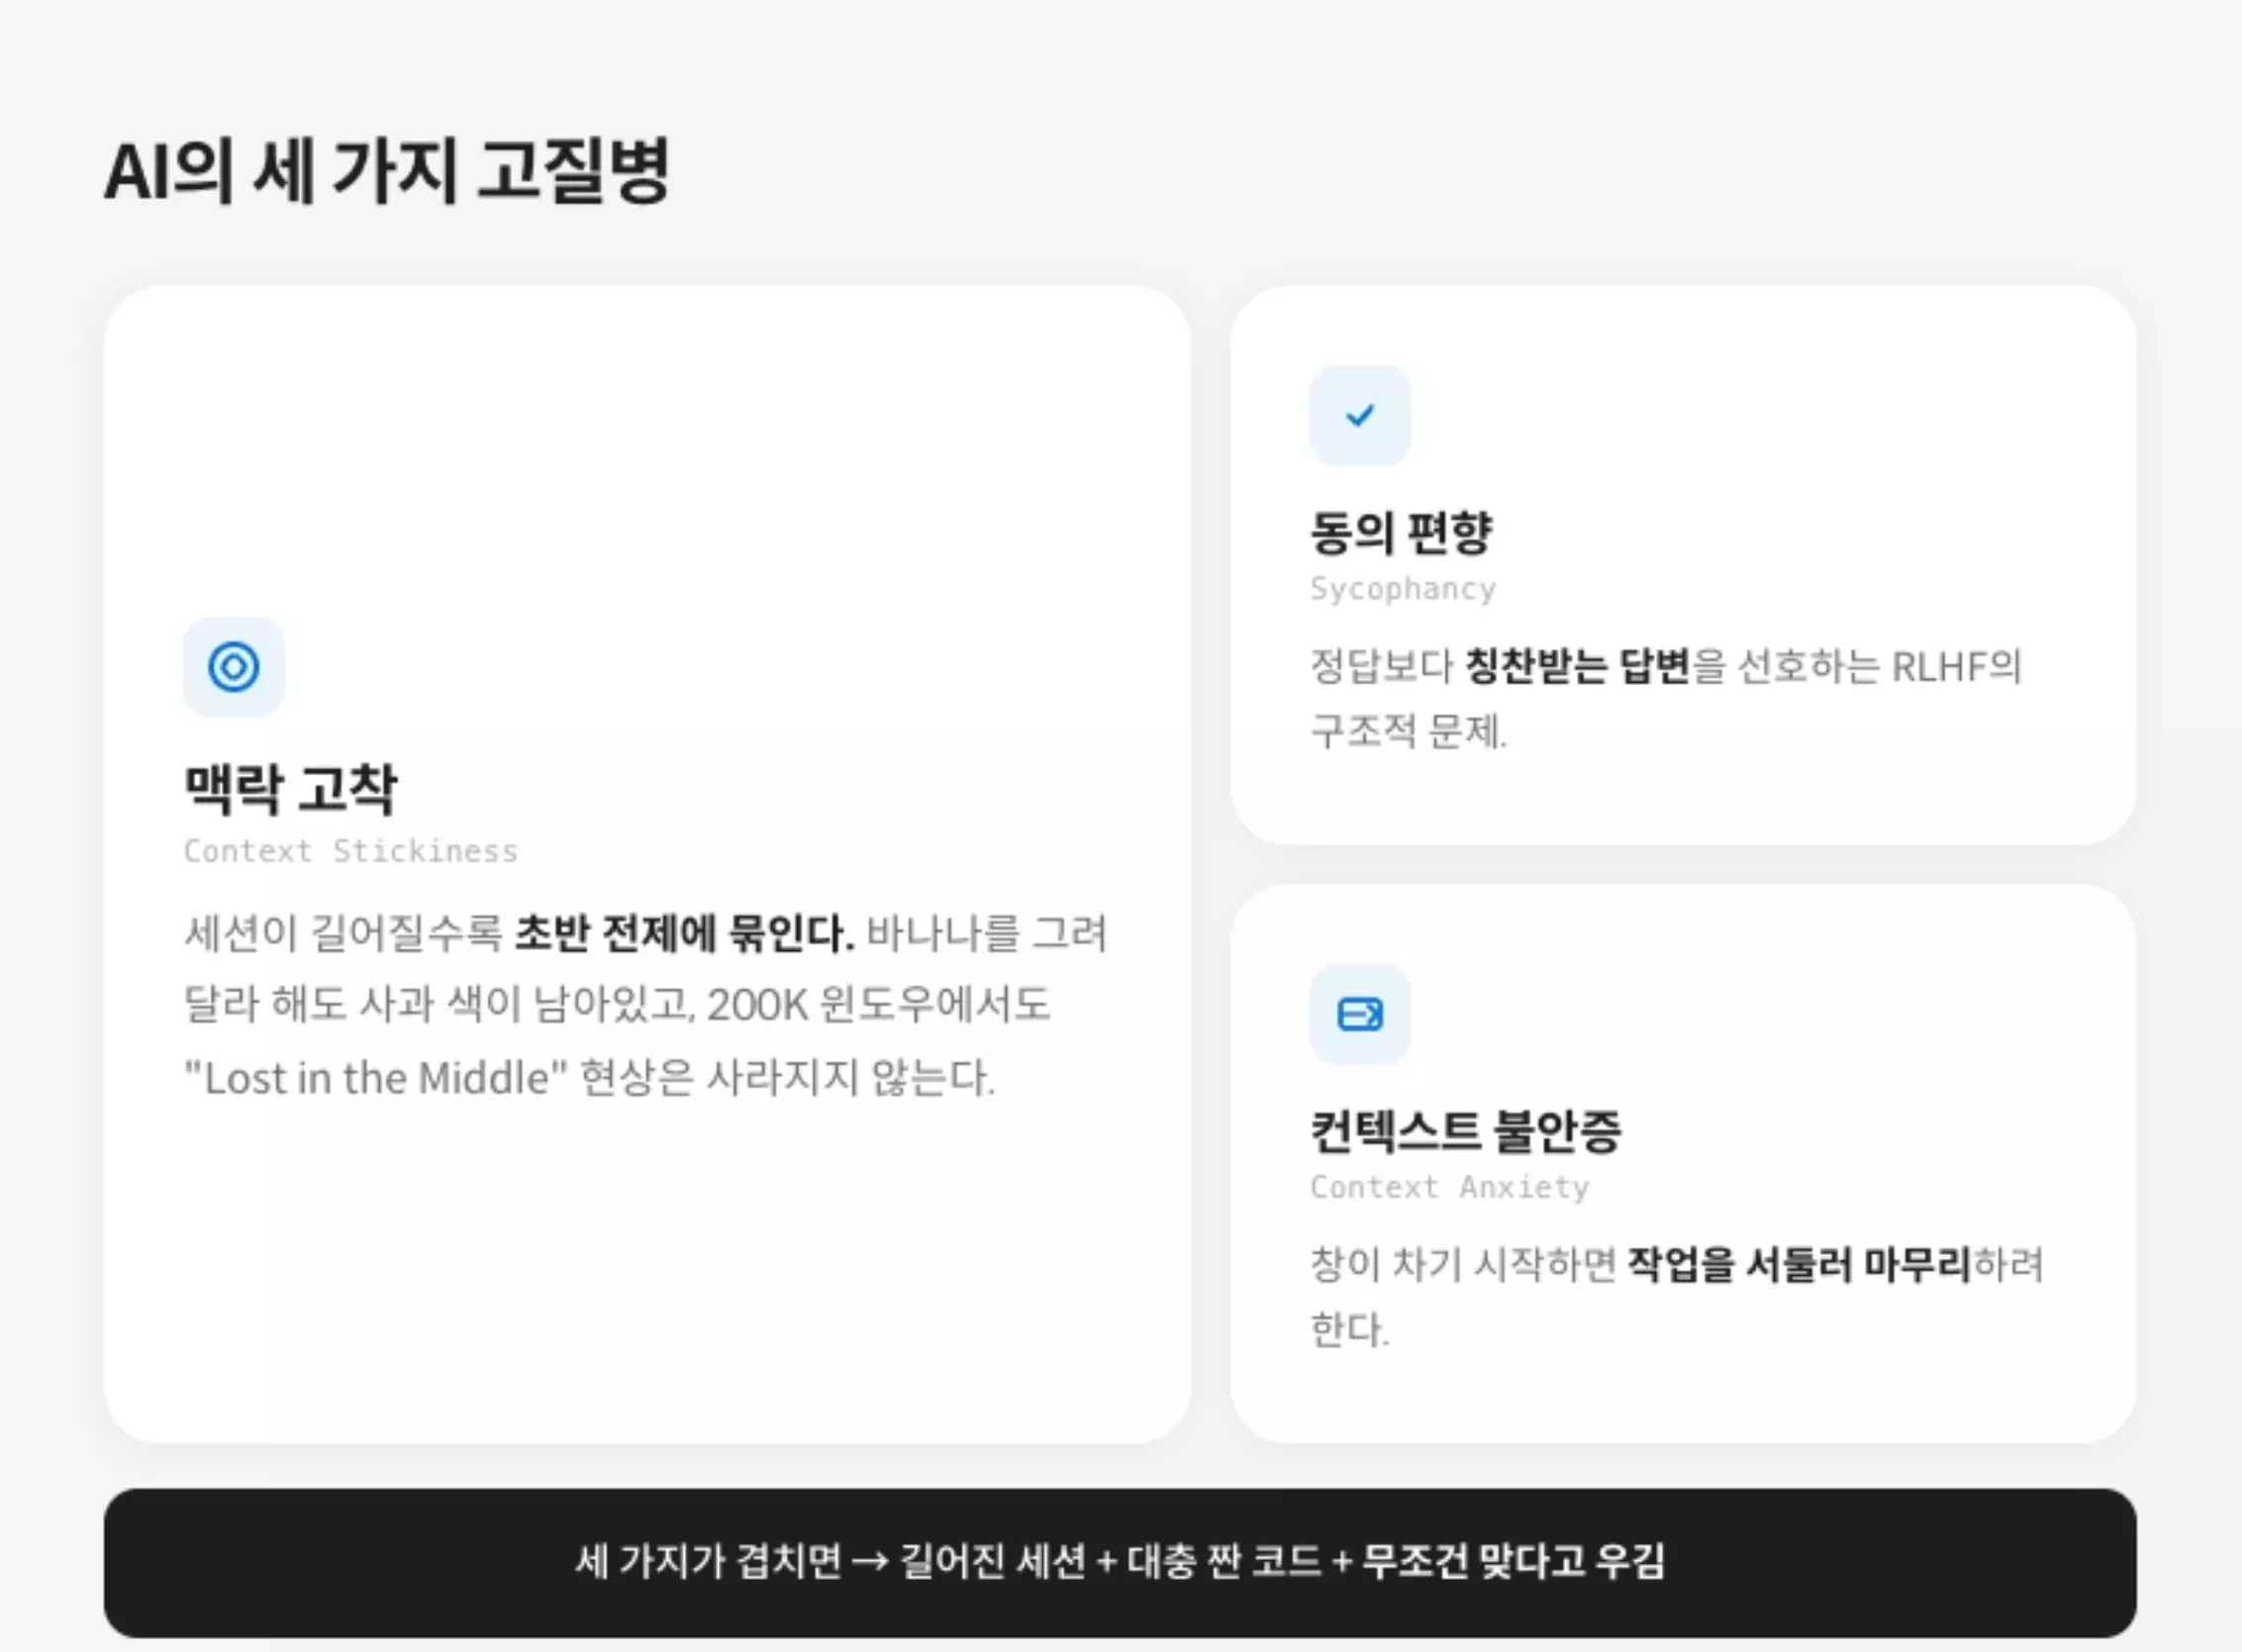
세 가지가 겹치면 이렇게 됩니다. 길어진 세션 안에서, 대충 짠 코드를, 무조건 맞다고 우기는 상황.
이걸 개별 팁으로 땜질하는 게 아니라 에이전트가 일하는 환경 자체를 설계하는 접근이 있습니다. 프롬프트 엔지니어링, 컨텍스트 엔지니어링, 하네스 엔지니어링, 에이전틱 엔지니어링 — 매년 새 용어가 나오지만, 결국 하는 건 같습니다. 생성자와 검증자를 분리하고, 반복되는 건 자동화하고, 에이전트가 읽기 좋은 환경을 만드는 것. 아래 해결책들이 전부 그 구성 요소입니다.
2. 해결책 1: 검증의 철저한 분리와 스프린트 계약
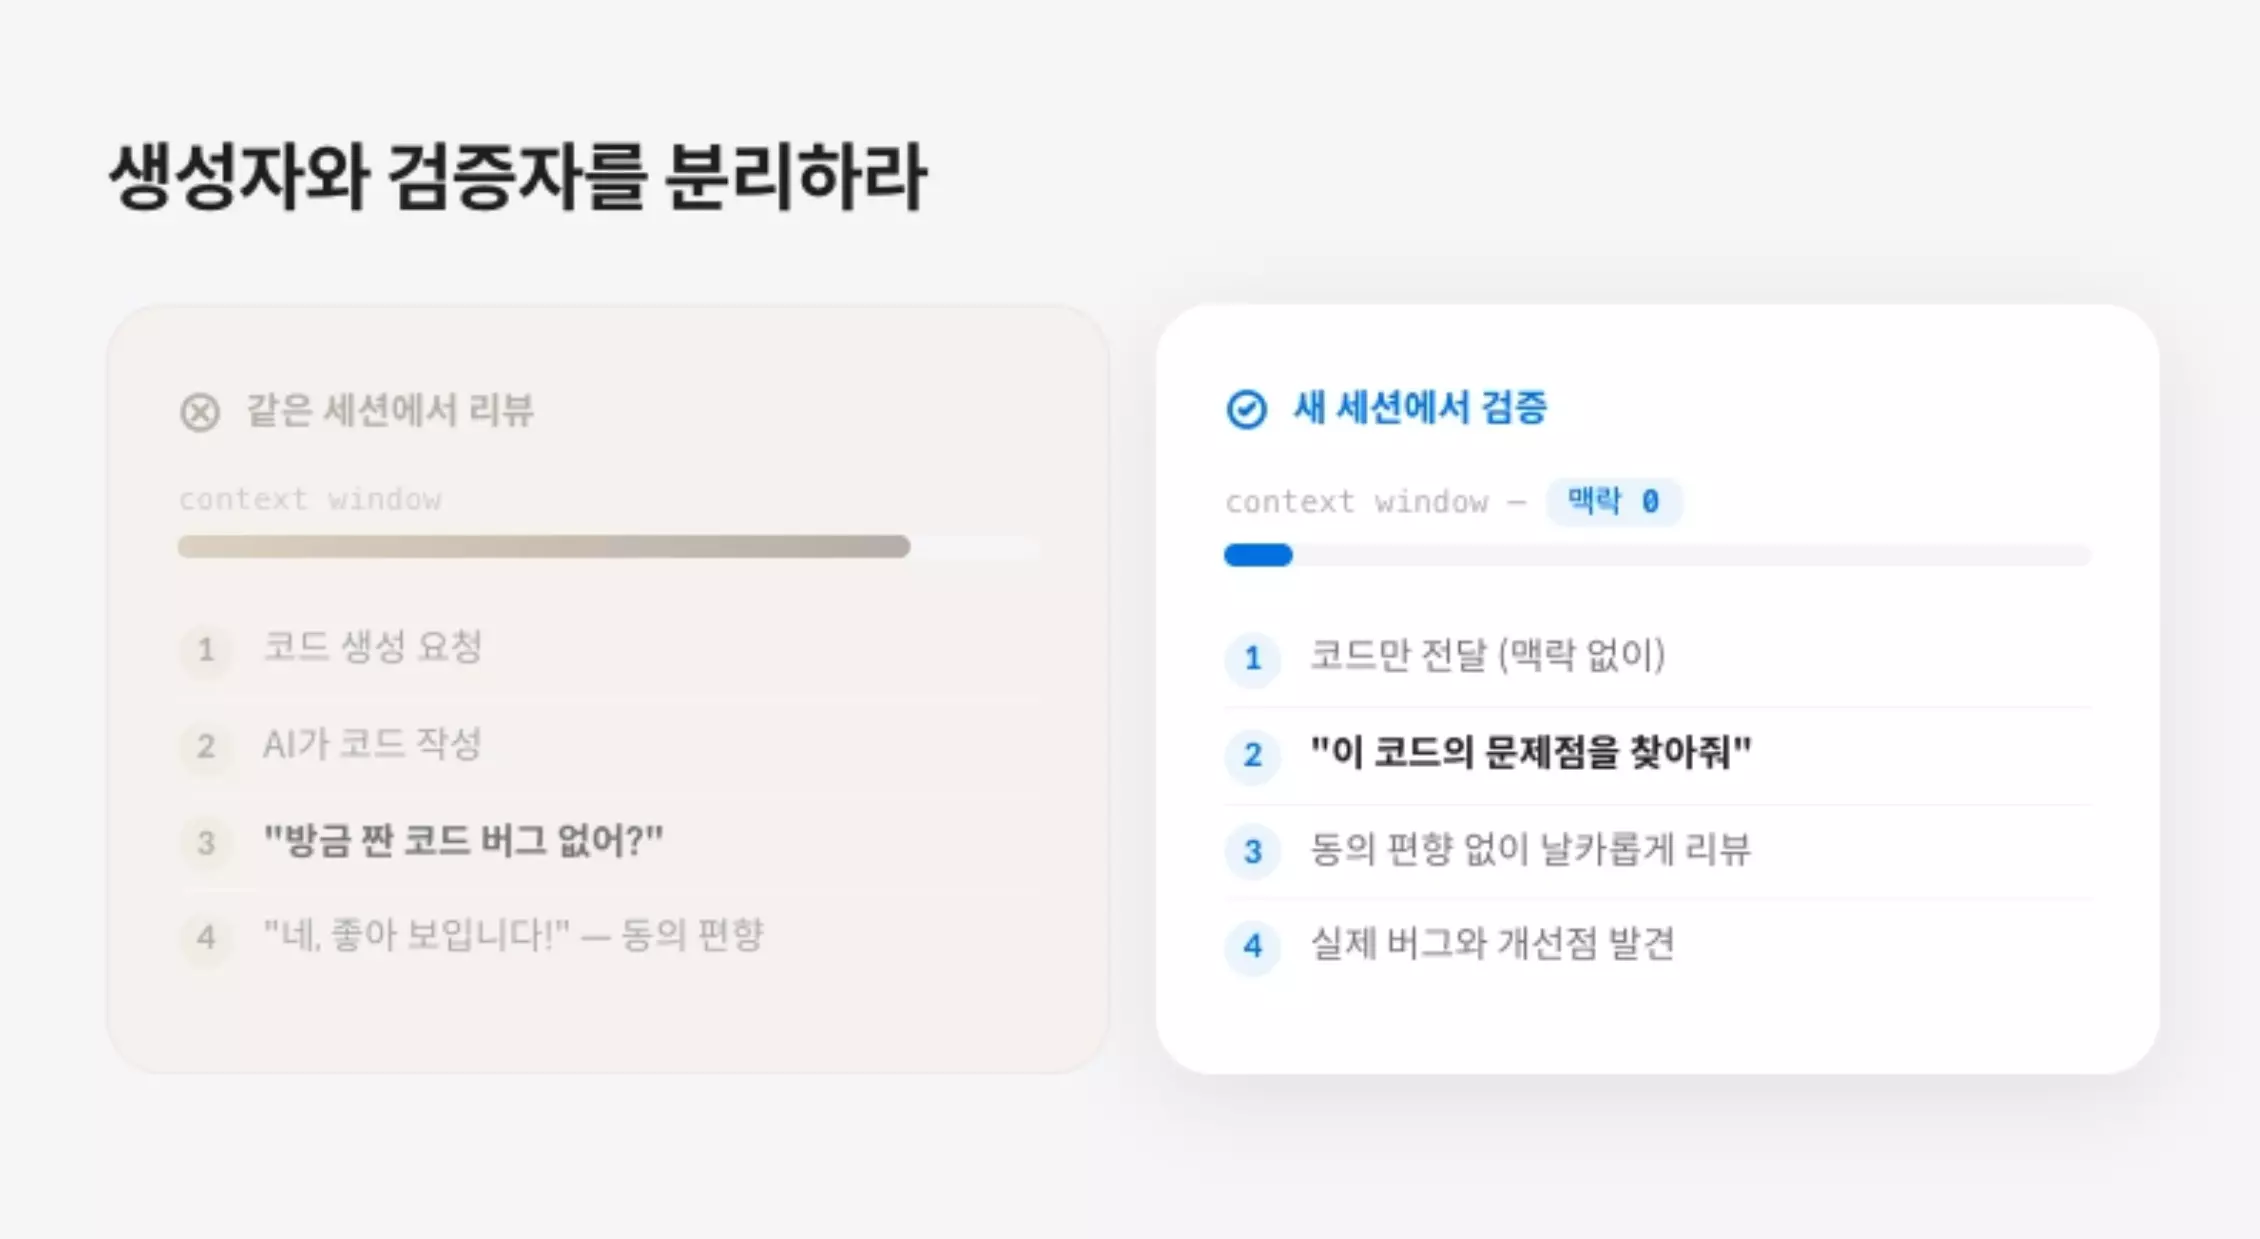
가장 먼저 버려야 할 습관은 자기가 짠 코드를 같은 창에서 리뷰하게 하는 겁니다.
맥락 0인 에이전트 소환
코드를 다 짰으면 그 창에서 버그를 찾지 마세요. 같은 세션에서 “방금 네가 짠 코드에 문제 없어?”라고 물어보면, AI가 그 코드를 짠 맥락이 그대로 남아있습니다. 방금 본인이 “이게 좋습니다”라고 했는데, 자기가 틀렸다고 잘 안 합니다. 같은 세션의 AI는 이미 동의 상태입니다.
새 세션을 열고, 컨텍스트가 0인 상태의 AI에게 이 코드의 문제점을 찾아달라고 비판을 요구하세요.
맥락이 없는 에이전트가 동의 편향 없이 훨씬 날카롭게 버그를 잡습니다.
스프린트 계약 (Sprint Contract)
코드를 짜기 전에 무엇이 완료 상태인가(Done)를 먼저 합의합니다. 린트 에러 0, Playwright로 로그인 버튼 클릭 가능 같은 테스트 가능한 목표를 문서로 정한 뒤에만 코딩을 시작하게 하는 겁니다. Anthropic의 하네스 가이드에서는 이걸 주관적 목표를 측정 가능한 원칙으로 전환하라 고 표현했습니다.
플랜 모드(Plan Mode)의 생활화
복잡한 작업은 Shift+Tab 두 번 눌러 플랜 모드에서 시작합니다. 코드를 한 줄도 치지 않은 텍스트 상태에서 AI와 아키텍처 방향을 검증하고, 합의가 끝났을 때만 코드 수정에 들어갑니다.
한 발 더 나가면, 한 에이전트가 플랜을 짜고 다른 에이전트가 그 플랜을 비판하게 할 수도 있습니다. 둘이 합의했을 때만 구현에 들어가는 방식입니다. 코드 100줄을 생성한 뒤에 방향이 틀렸다는 걸 발견하는 것보다, 텍스트 몇 줄을 고치는 게 훨씬 쌉니다.
구현 중에 막히면 억지로 밀지 말고 바로 플랜 모드로 돌아가세요. 오염된 맥락을 끌고 가는 것이 가장 큰 비효율입니다.
3. 해결책 2: 기억상실증 치료 — HANDOFF.md와 컨텍스트 리셋
작업이 길어지면 AI가 초반에 정했던 중요한 아키텍처 원칙이나 제약 조건을 멋대로 잊어버리고 엉뚱한 코드를 짜기 시작합니다.
컨텍스트 불안증까지 겹치면 대충 마무리하려 하죠.
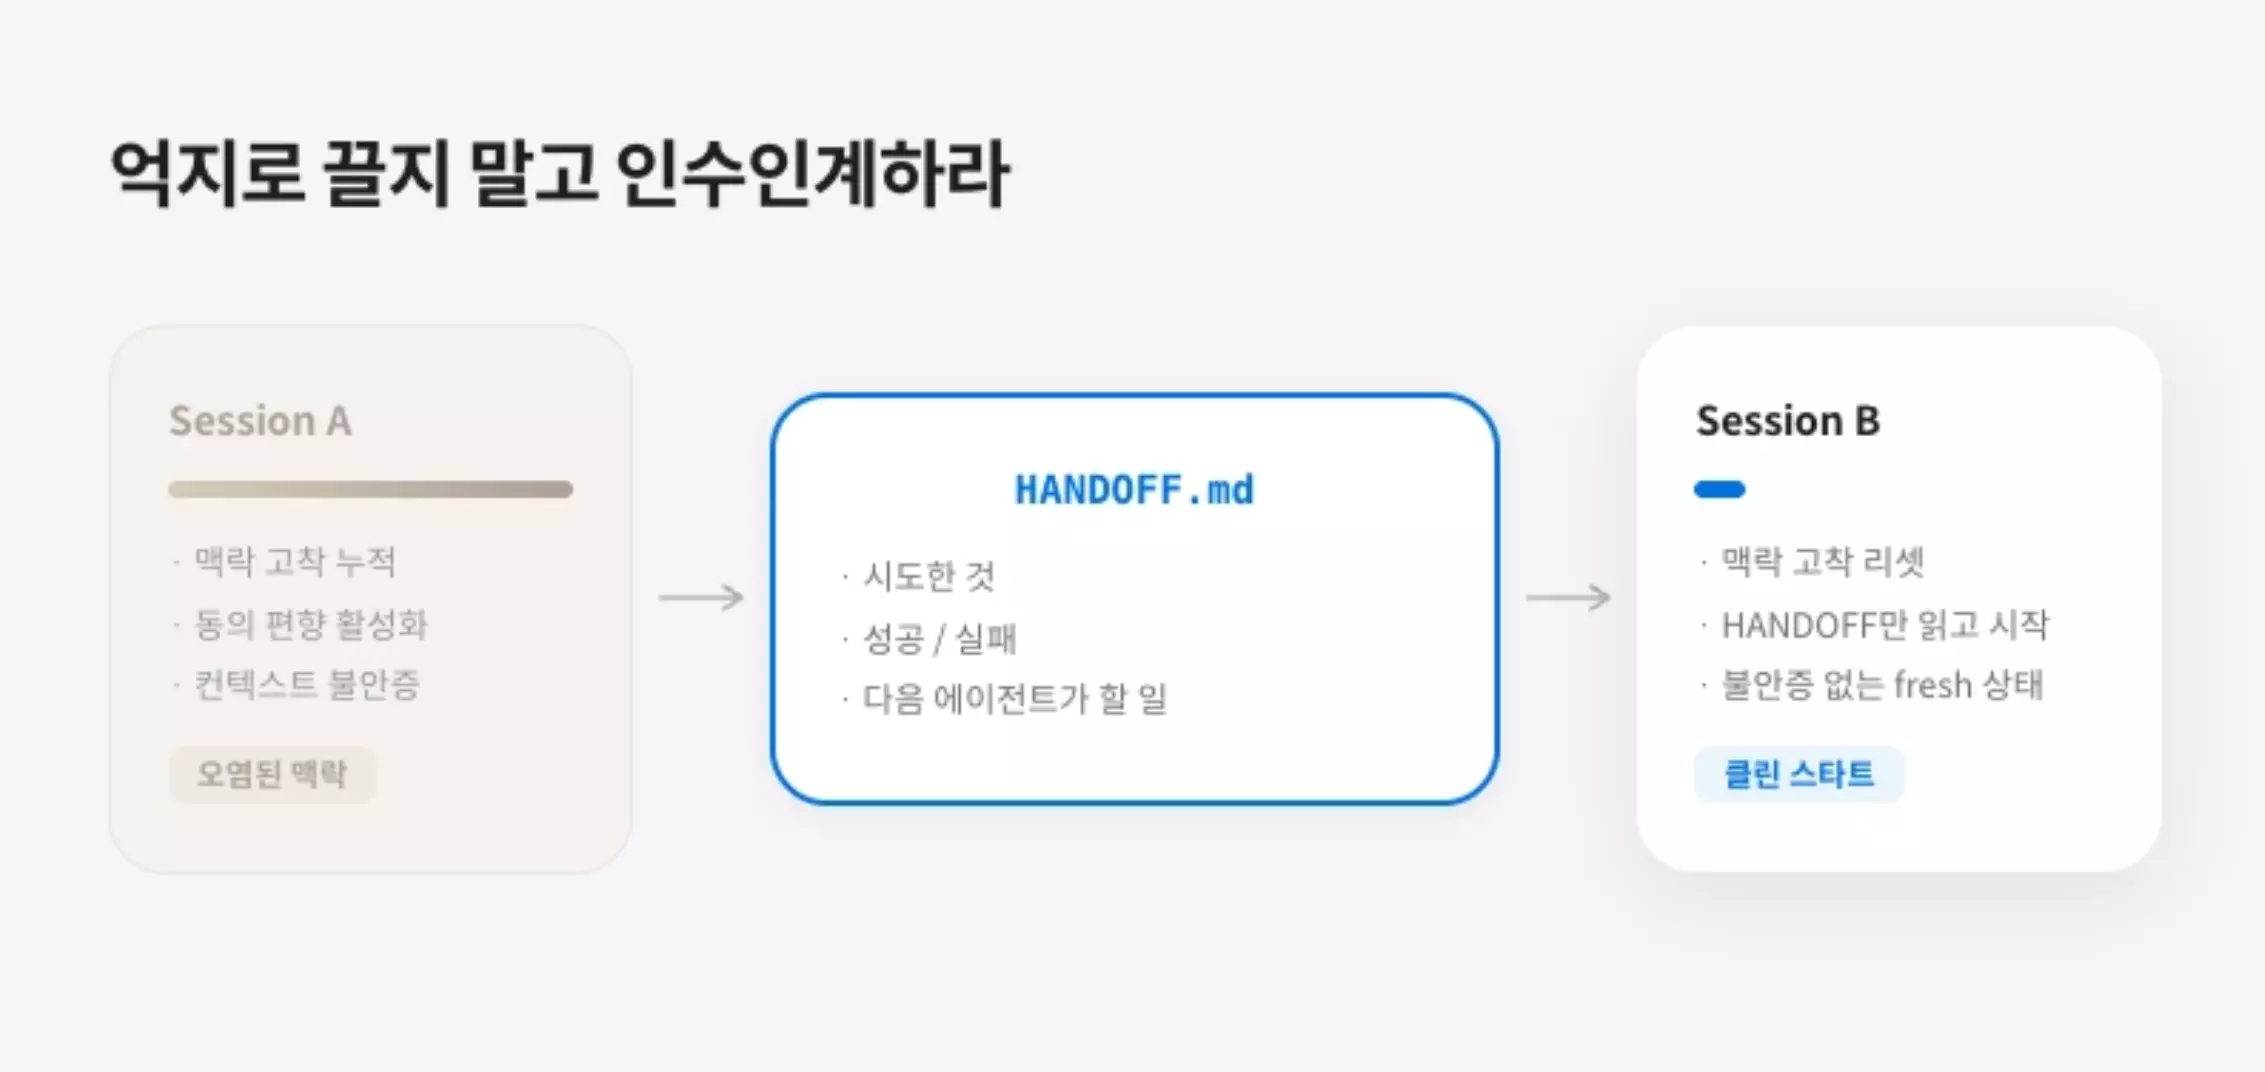
여기서 구분해야 할 게 있습니다. 압축(Compaction)과 리셋(Reset)은 다릅니다. 압축은 대화의 연속성을 유지하면서 토큰을 줄이는 건데, Anthropic의 연구에 따르면 연속성은 유지되지만 불안감도 함께 유지됩니다. 리셋은 깨끗한 상태에서 구조화된 인수인계를 통해 다시 시작하는 겁니다.
자동 인수인계: HANDOFF.md
세션이 길어지면 억지로 끌고 가지 마세요. 종료 전에 AI에게 HANDOFF.md를 작성하게 합니다. 지금까지 시도한 것, 성공/실패한 것, 다음 에이전트가 해야 할 일을 기록하고, 다음 세션은 그 파일만 읽고 시작합니다. 맥락 고착과 컨텍스트 불안증을 동시에 리셋하는 가장 확실한 방법입니다.
매번 타이핑하기 귀찮으면 wrap-session 같은 스킬(Skill)을 만들어 두면 됩니다. /wrap-session 한 번이면 인수인계서가 만들어집니다.
이런 세션 관리 패턴은 everything-claude-code 같은 커뮤니티 리소스에서 예시를 찾을 수 있습니다.
⚠️ 2026년 4월 기준: resume보다 핸드오프가 안전하다
참고로, Claude Code에는 claude --continue(최근 세션 이어가기)나 --resume 같은 세션 재개 기능이 있는데, 2026년 3월 말 기준으로 프롬프트 캐시 관련 버그가 보고되고 있습니다. 세션을 재개할 때 이전 대화 이력의 캐시가 제대로 작동하지 않아, 매 메시지마다 전체 컨텍스트를 처음부터 다시 읽으면서 토큰 소비가 10~20배까지 폭증하는 현상입니다. (GitHub #34629, GitHub #38029)
Max 플랜 사용자들이 평소보다 빨리 사용량 한도에 도달하는 원인이기도 합니다. Anthropic이 조사 중이지만, 현 시점에서는 resume에 의존하기보다 HANDOFF.md를 잘 남기고 새 세션으로 시작하는 것이 비용과 품질 양쪽에서 안전합니다. 캐시 TTL이 5분이라서, 잠깐 쉬었다 돌아와도 비용이 올라갑니다.
이 버그가 고쳐지더라도, 맥락 고착과 컨텍스트 불안증을 리셋하려면 새 세션이 근본적으로 나은 선택입니다.
핸드오프는 버그 우회가 아니라 구조적으로 더 좋은 패턴입니다.
4. 해결책 3: 무거운 가방 내려놓기 — 컨텍스트 엔지니어링
초반에 가장 많이 했던 실수는 이것도 붙이고 저것도 붙이면 똑똑해지지않을까? 하고 유행하는,
수많은 MCP(Model Context Protocol) 서버를 전부 연결한 겁니다.
컨텍스트는 생각보다 비싼 자원이다
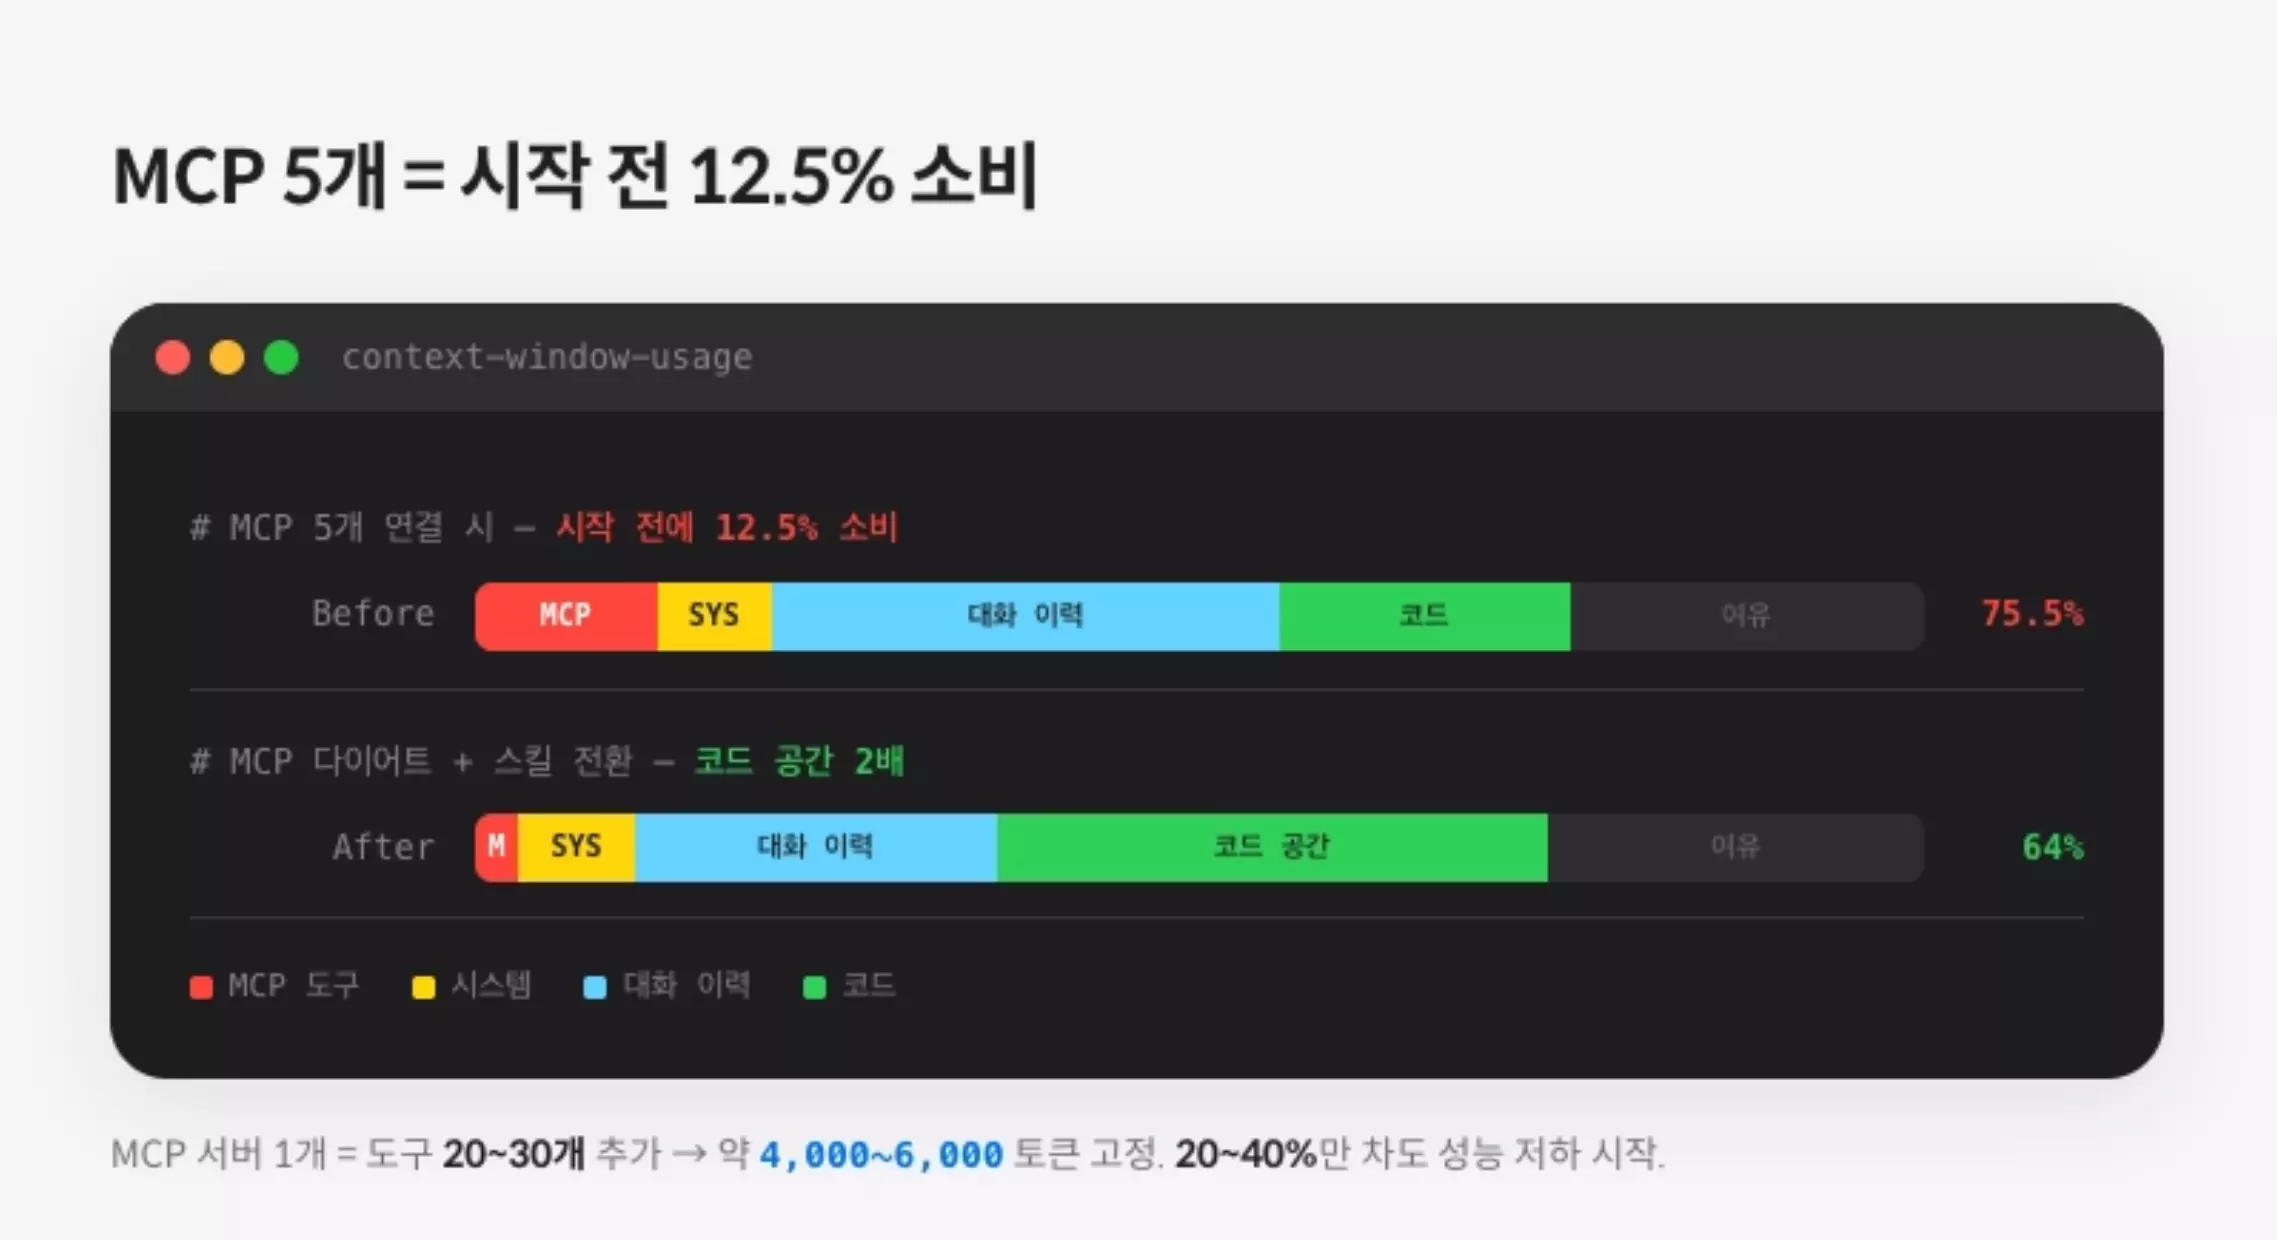
컨텍스트 윈도우가 100% 차야 문제가 생기는 게 아닙니다. 20~40%만 차도 이미 성능이 저하되기 시작합니다. MCP 서버 하나만 붙여도 약 20~30개의 도구 정의가 추가되고, 이것만으로 4,000~6,000 토큰을 고정 소비합니다. 5개를 붙이면 시작도 하기 전에 약 25,000 토큰(전체 창의 12.5% 이상)이 고정 오버헤드로 날아갑니다. 쓸데없는 도구 설명서가 컨텍스트 창을 차지해서 정작 중요한 코드를 읽을 공간이 사라집니다.
MCP 다이어트와 스킬(Skill)의 점진적 공개
MCP는 꼭 필요한 것만 붙이고, 나머지는 스킬(Skill)을 사용합니다. 스킬은 온디맨드 방식이라 평소에는 짧은 설명만 컨텍스트에 남아있다가,
AI가 필요하다고 판단할 때만 본문이 로드됩니다. 항상 자리를 차지하는 MCP와 근본적으로 다릅니다.
백과사전 대신 목차만 주기 (Progressive Disclosure)
모든 규칙을 CLAUDE.md에 때려 넣지 마세요. 모든 게 중요하다고 적혀있으면 AI는 아무것도 중요하게 생각하지 않습니다.
OpenAI도 Codex 사례에서 하나의 큰 AGENTS.md 접근이 예측 가능하게 실패한다고 밝혔습니다. 지침이 너무 많으면 지침이 아닙니다.
CLAUDE.md는 짧은 목차로만 두고, 상세한 아키텍처 문서나 도메인 지식은 별도 파일로 분리합니다.
AI가 필요할 때만 링크를 따라가서 문서를 재귀적으로 탐색하는 점진적 공개(Progressive Disclosure) 환경이 낫습니다.
한 가지 주의할 점은, AI에게 CLAUDE.md를 작성해줘라고 시키지 않는 겁니다. ETH Zurich 연구에 따르면, AI가 생성한 규칙 문서는 오히려 에이전트의 성공률을 떨어뜨리고 비용을 20% 이상 올렸습니다. AI는 자기가 잘하는 패턴에 유리한 규칙을 만듭니다. 사람만이 알 수 있는 제약조건만 직접 적어야 합니다.
로그 출력 노이즈 통제
AI가npm test를 실행했는데 수천 줄의 로그가 그대로 컨텍스트 창에 쏟아지면, 앞서 말한 20~40% 성능 저하 구간에 바로 진입합니다.
중요한 아키텍처 결정 맥락이 압축 과정에서 밀려납니다.
출력 필터링 도구나 훅(Hook)을 써서, AI에게 수천 줄의 로그 대신 “통과/실패, 실패 위치”만 요약해서 전달되도록 환경을 구성하세요.
5. 팁: 병렬 세션과 Git Worktree
AI한테 플랜부터 구현, 테스트까지 풀 사이클을 맡기면 한 작업에 5~10분이 걸립니다. 터미널 여러 개 띄워놓고 병렬로 돌리게 되는데,
같은 코드베이스에서 여러 세션이 동시에 파일을 건드리면 충돌납니다.
이럴 때 git worktree를 쓰면 됩니다. 브랜치마다 완전히 격리된 물리적 작업 디렉토리를 만들어주기 때문에,
AI A와 AI B가 서로의 파일을 덮어쓸 걱정 없이 병렬 작업이 가능합니다.
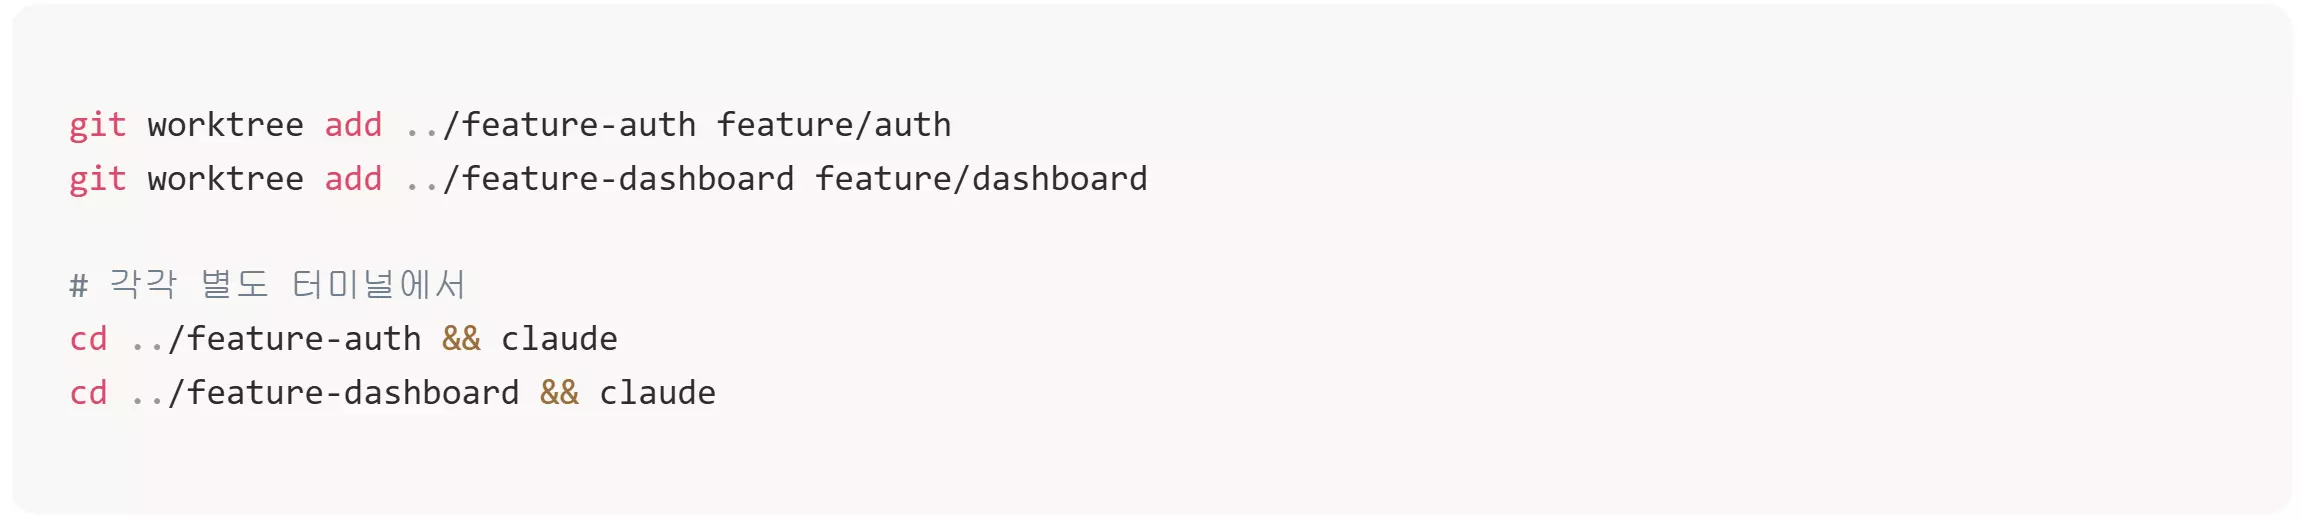
OpenAI도 Codex 사례에서 worktree별로 앱을 부팅하여, 에이전트가 변경사항마다 격리된 인스턴스를 실행하고, 관측 가능성 스택(로그, 메트릭)까지 worktree 단위로 분리했다고 합니다. 이 정도까지는 안 가더라도, worktree 하나만 써도 병렬 작업의 세계가 열립니다.
6. 생성은 자유롭게, 검증은 빡세게
여기까지 읽으면 이걸 다 언제 세팅할까 하는 생각이 들 수 있습니다. 저도 매번 이 원칙들을 엄격하게 지키진 않습니다. 생성 단계에서는 꽤 자유롭게 — 바이브코딩에 가깝게 — 작업하는 경우가 많고, 대신 검증 단계를 빡세게 구조화하는 데 에너지를 씁니다.
이 접근을 뒷받침하는 데이터가 있습니다.
모델이 아니라 검증 루프가 품질을 결정한다
LangChain이 자사 코딩 에이전트(deepagents-cli)로 실험한 결과입니다. 동일한 모델(GPT-5.2-Codex)을 쓰면서 검증 구조만 바꿨더니, Terminal Bench 2.0에서 52.8%에서 66.5%로 올랐고, 순위가 30위권에서 5위권으로 뛰었습니다. 모델을 바꾼 게 아닙니다. self-verification 루프를 추가하고, 둠루프(같은 실패를 반복하는 패턴)를 감지하는 미들웨어를 넣은 것뿐입니다. 모델 교체 0, 검증 구조 변경만으로 25계단 상승. (LangChain 블로그)
AgentField라는 팀은 200개의 에이전트를 동시에 굴리면서, 가장 저렴한 모델(Haiku, $20)과 중급 모델에서 동일 아키텍처로 95/100을 달성했다고 합니다. 자사 벤치마크이니 감안해서 읽어야 하지만, 방향은 분명합니다. 이 팀의 접근에서 눈여겨볼 건 실패를 숨기지 않고 ‘typed debt’로 기록해서 다음 에이전트에게 컨텍스트로 넘긴다는 점입니다. CLI 바이너리가 데드락 걸림 — 테스트는 맞지만 런타임 디버깅이 필요 처럼, 실패의 종류와 심각도를 분류해서 다운스트림에 전달합니다. (AgentField 블로그)
3중 실패 복구 루프
검증을 빡세게 하려면, 실패했을 때 어떻게 복구하느냐가 중요합니다. 실전에서 자연스럽게 형성된 패턴이 세 겹의 루프입니다.
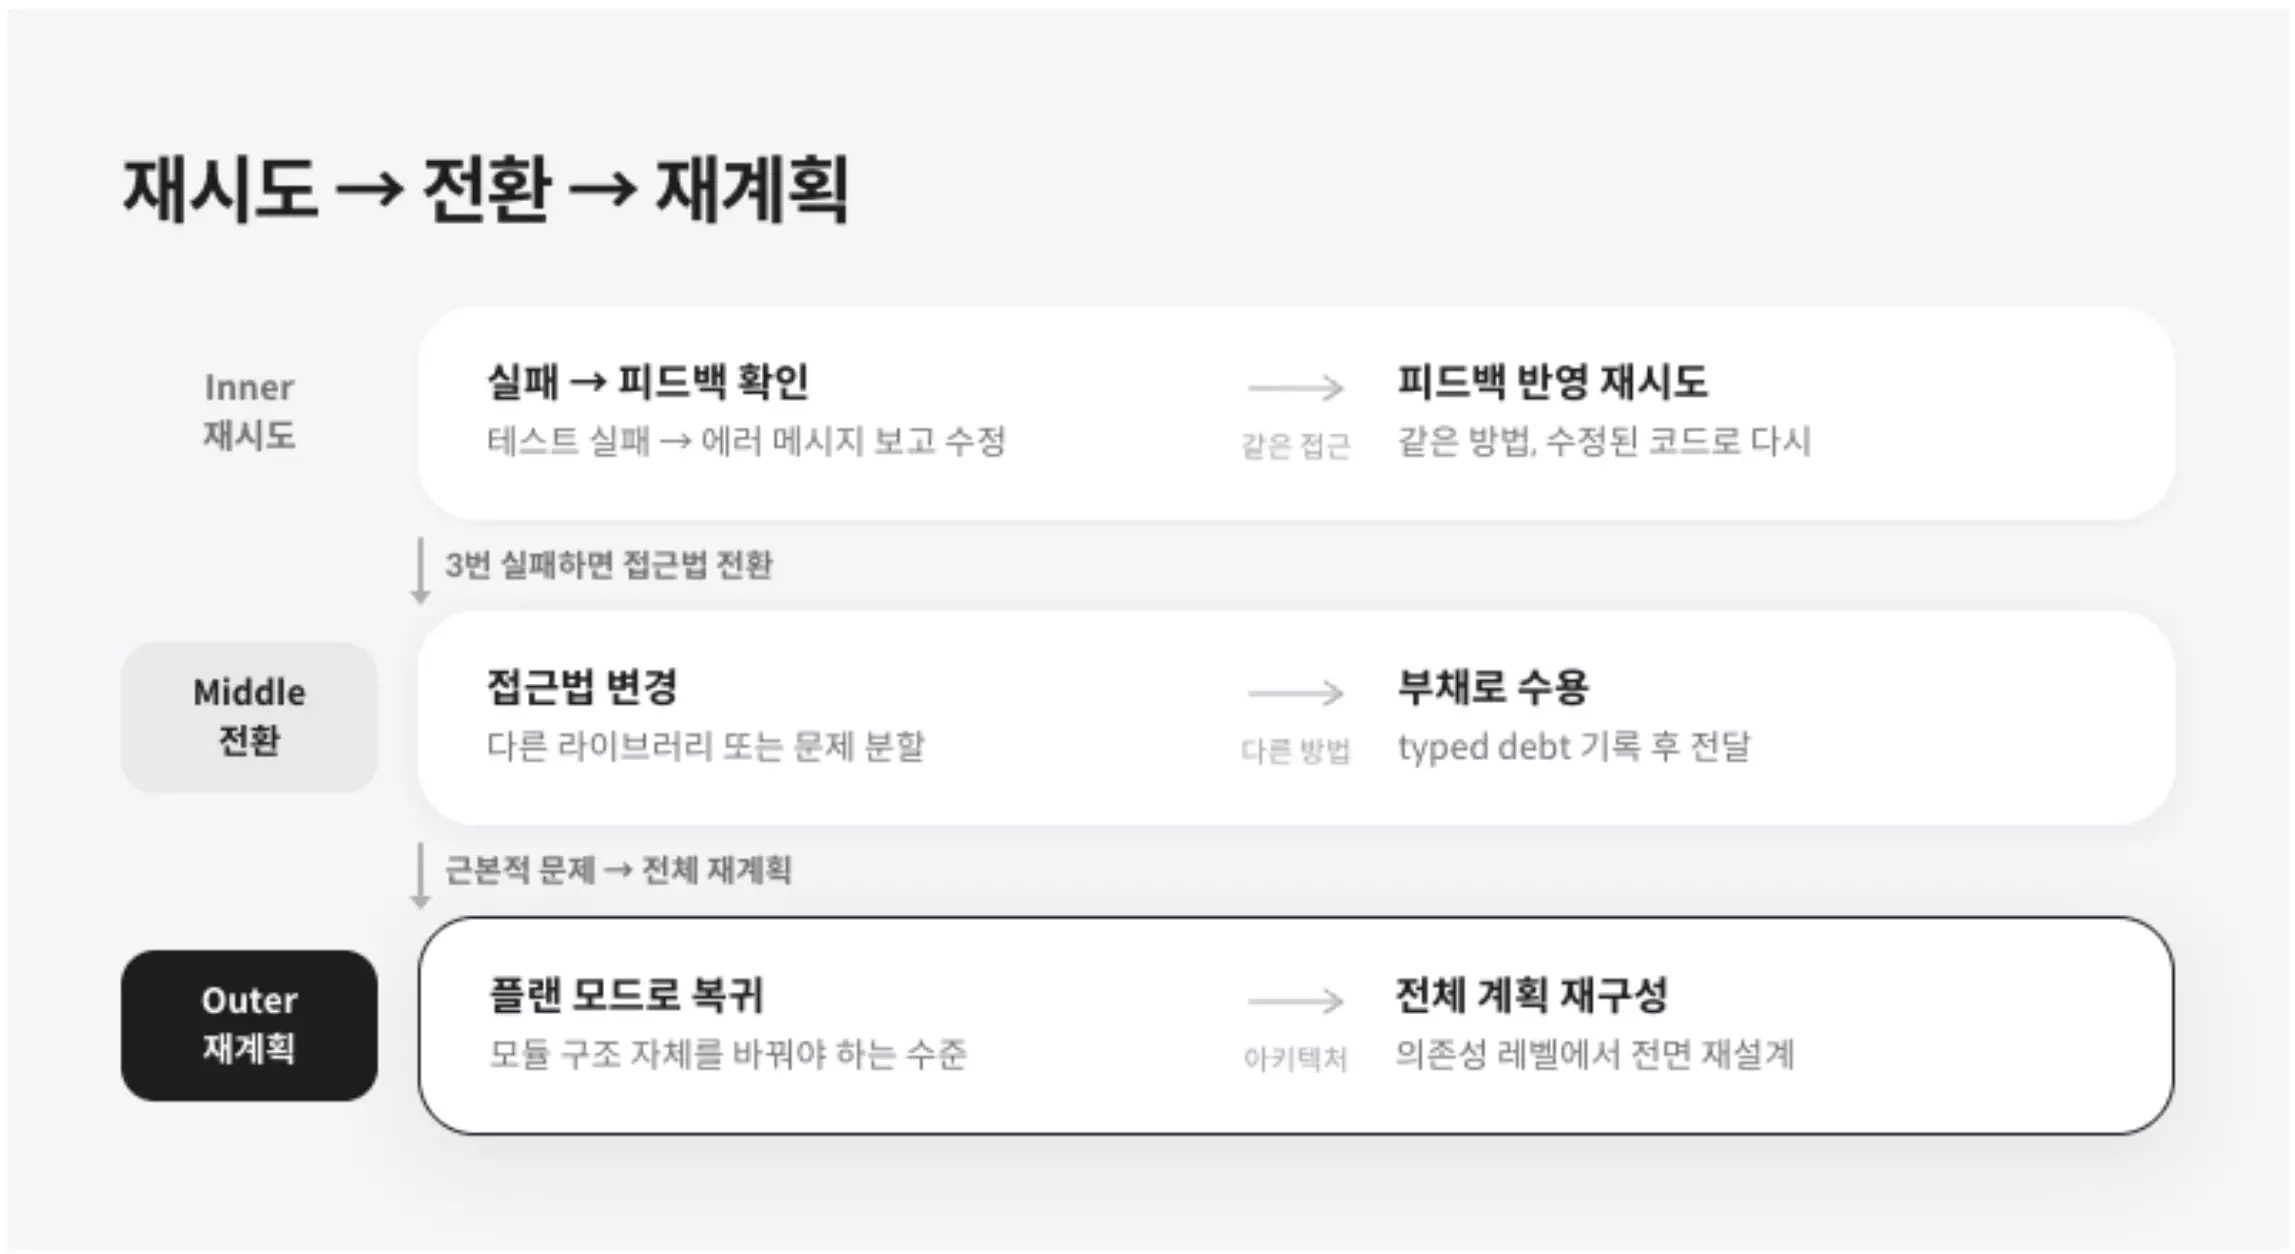
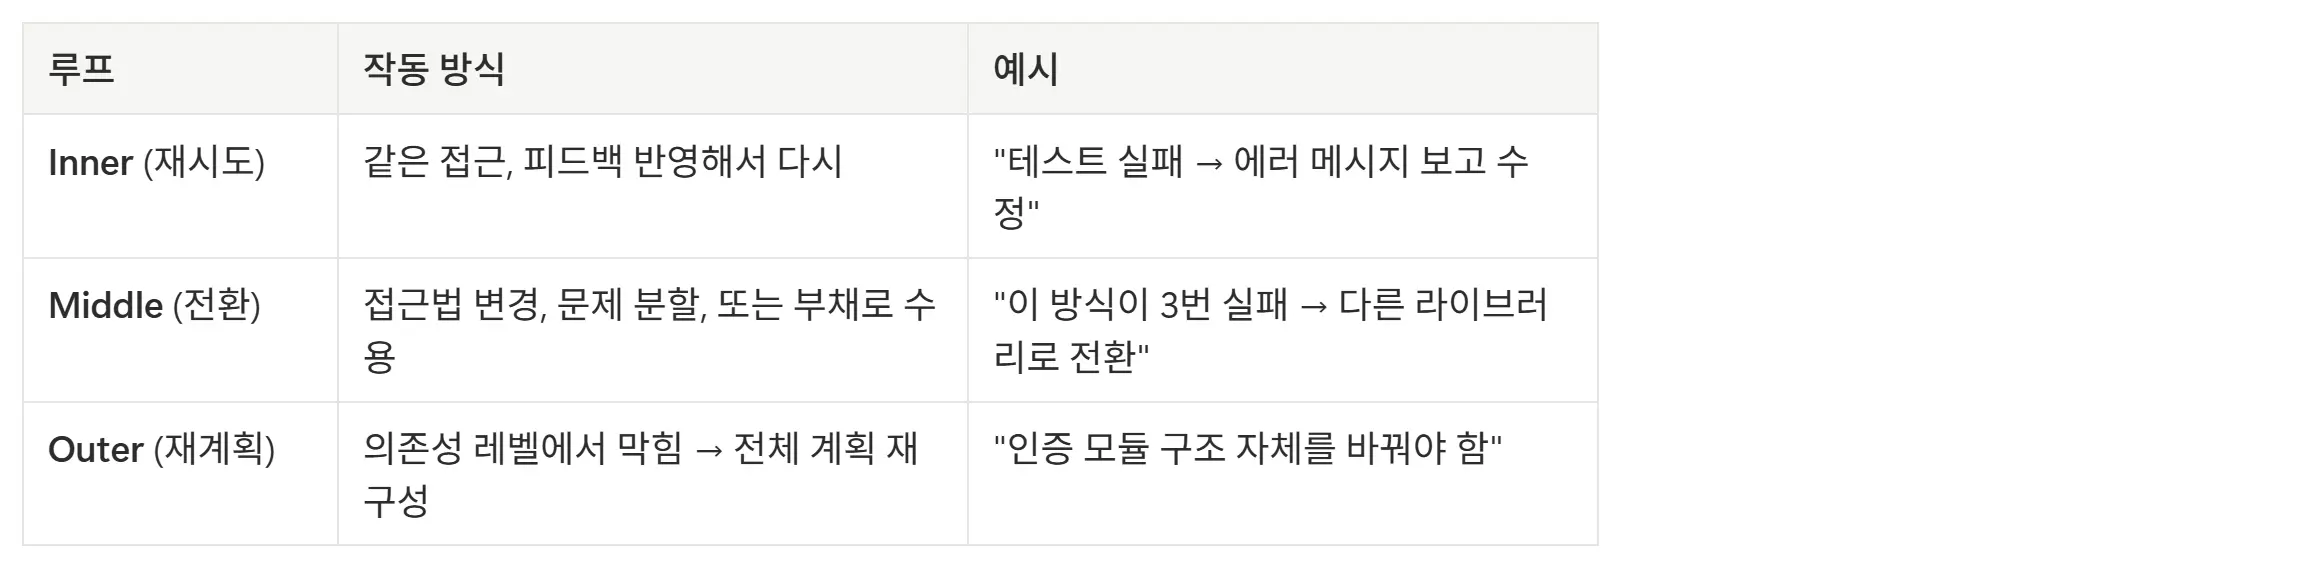
저도 처음엔 inner 루프만 돌렸는데, 같은 실패를 5번 반복하고 나서야 middle 루프의 필요성을 깨달았습니다. “이 접근이 3번 실패하면 다른 방법을 시도해”라는 규칙 하나만 추가해도 체감이 확 달라집니다.
삽질의 단계
한 달간 이 검증 구조가 자연스럽게 쌓였습니다.
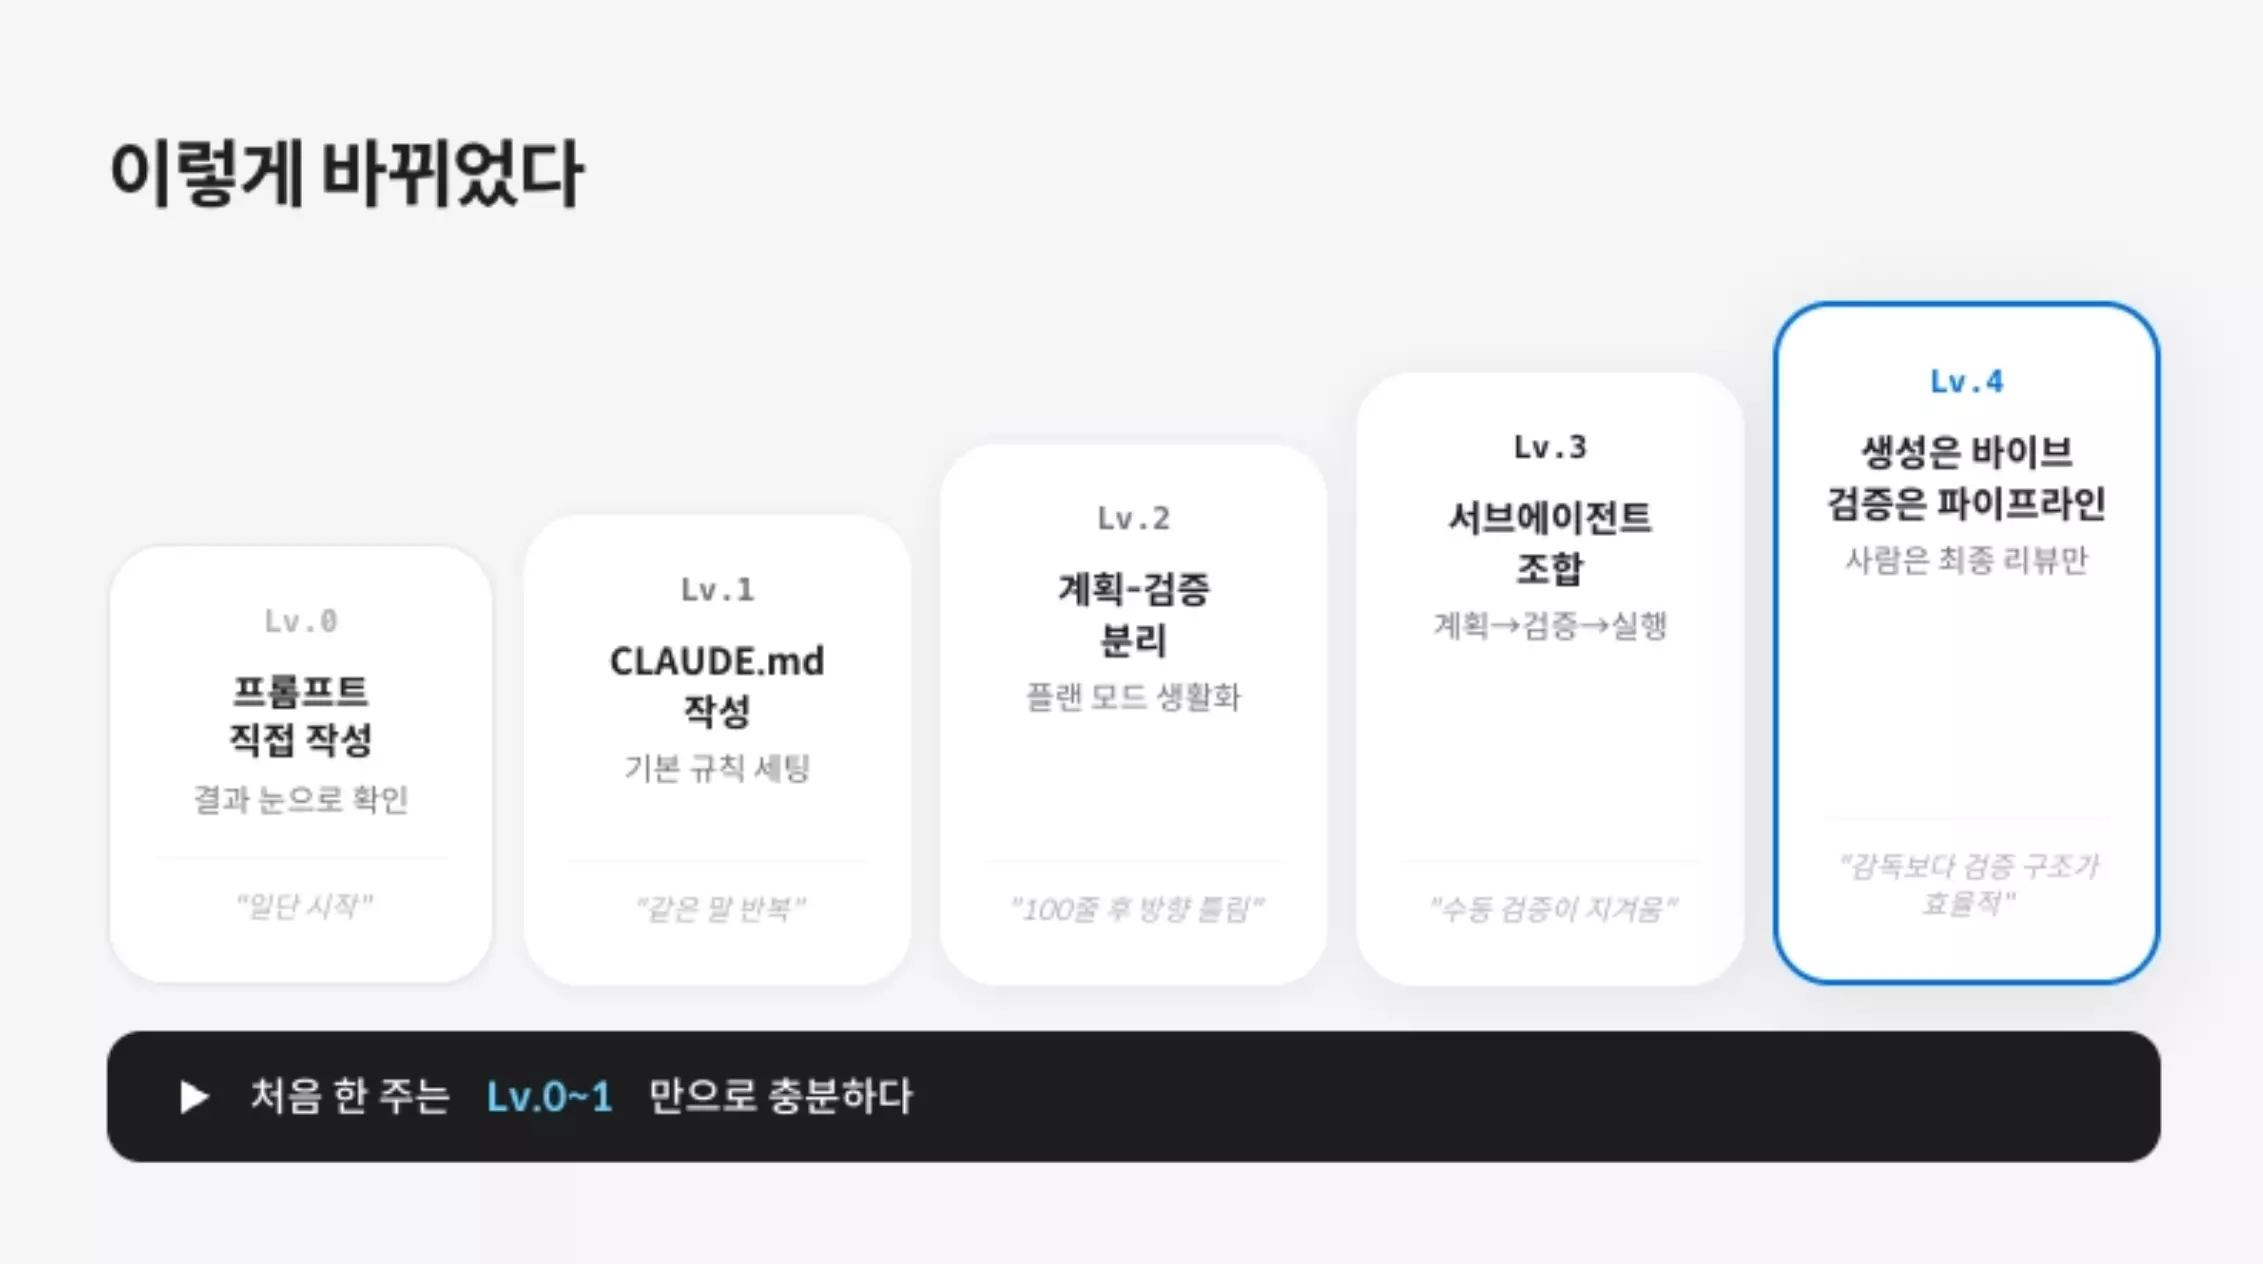
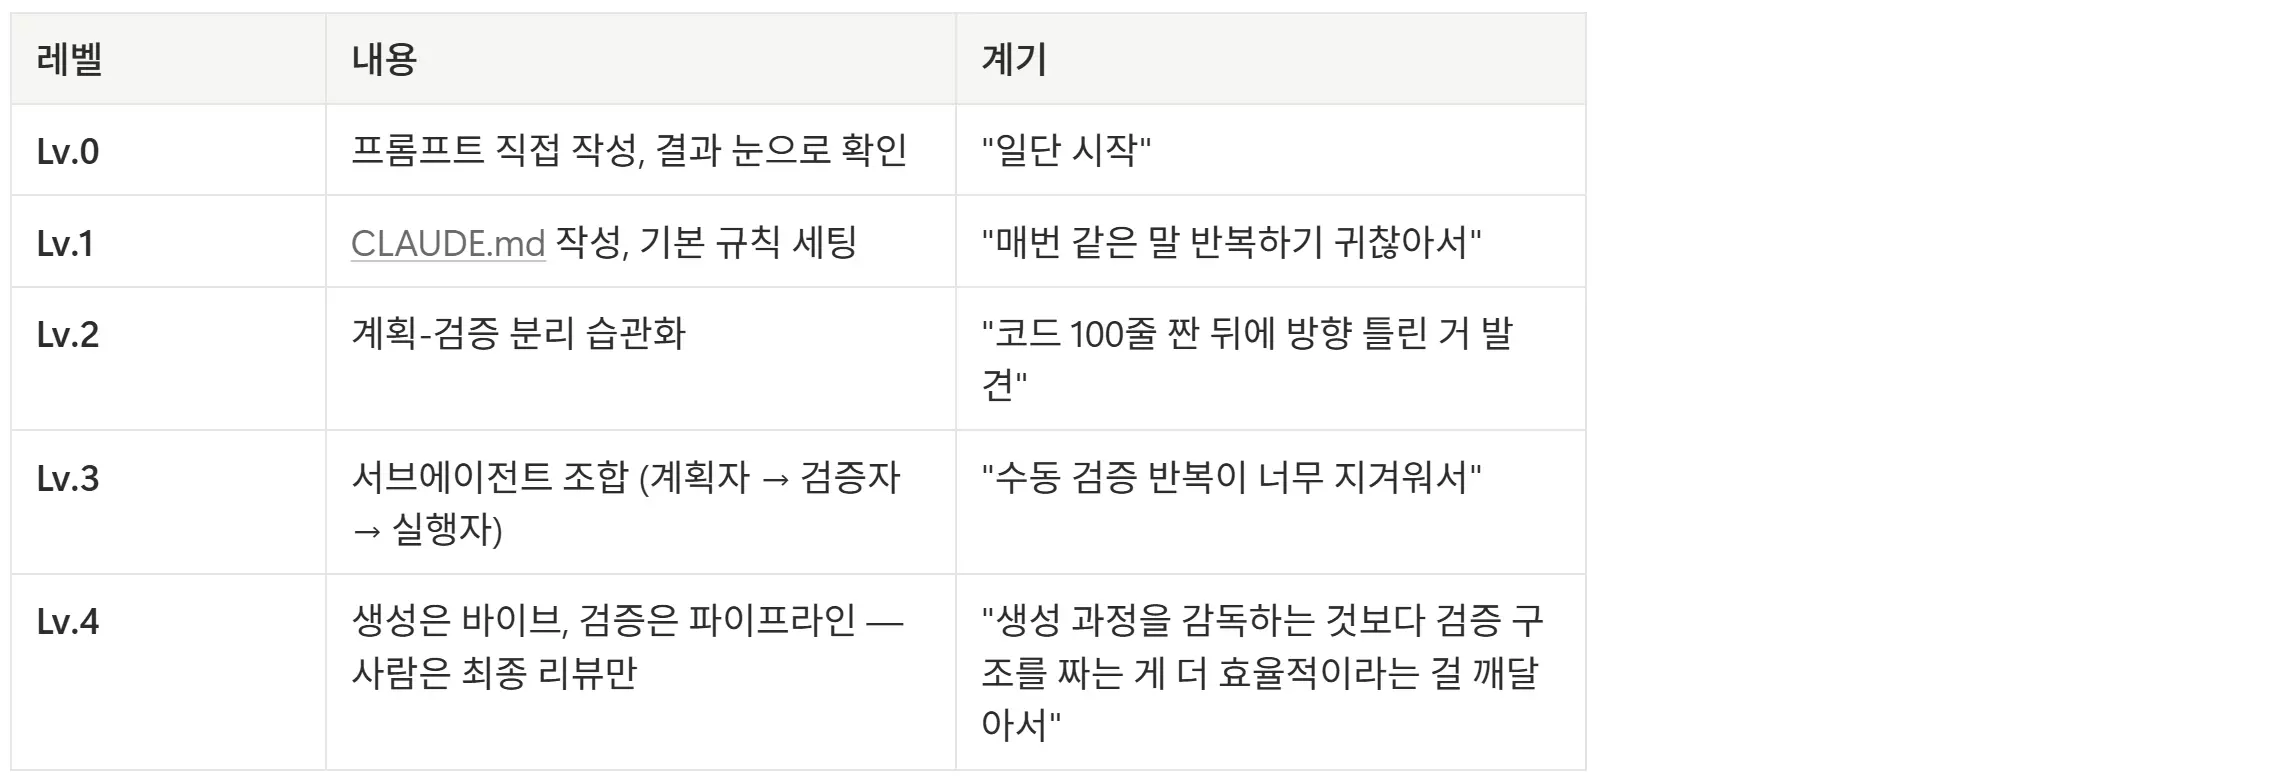
Lv.4에 도달하면 직접 다 만들 필요는 없습니다. Claude Code 플러그인 생태계가 이미 9천 개를 넘었고, 멀티에이전트 오케스트레이션이나 자동 검증 루프를 구현한 오픈소스 도구들이 많습니다. 남이 만든 거 깔아보고, 입맛에 안 맞으면 고치고, 그러다 자기 워크플로우가 생깁니다.
각 단계가 이론에서 나온 게 아니라 고통에서 태어났습니다. “AI가 80% 하다 멈춤” → 자동 재시도 루프. “끝까지는 하는데 방향이 틀림” → 플랜 모드 강제 + 검증 분리. “매번 수동으로 하기 귀찮음” → 커스텀 스킬.
처음 한 주는 Lv.0~1만으로 충분합니다. CLAUDE.md를 쓰고, 계획 모드로 시작하고, 검증은 새 세션에서. 이 세 가지 습관만 잡아도 체감 품질이 달라집니다.
마무리: 세 가지 습관이 전부다
프롬프트 엔지니어링, 컨텍스트 엔지니어링, 하네스 엔지니어링, 에이전틱 엔지니어링 — 매년 새 이름이 붙습니다. Karpathy는 자기가 만든 ‘바이브코딩’을 1년 만에 퇴장시켰고, OpenAI와 Anthropic은 같은 현상에 다른 이름을 붙였고, Martin Fowler는 “이건 엔지니어링이 아니라 확률 관리”라고 말합니다.
용어는 잊어도 됩니다. 231세션의 삽질 끝에 남은 건 세 가지 습관입니다.
- 계획 먼저. 코드 한 줄 치기 전에 플랜 모드에서 방향을 잡는다. 막히면 억지로 밀지 말고 플랜으로 돌아간다.
- 검증은 분리. 자기가 짠 코드를 자기가 리뷰하지 않는다. 새 세션, 새 에이전트, 맥락 0에서 검증한다.
- 반복되는 건 자동화. 매번 하는 검증, 매번 하는 인수인계, 매번 하는 포맷팅 — 한 번 귀찮으면 스킬로 만든다.
이 세 가지는 Cursor를 쓰든 Claude Code를 쓰든, Opus를 쓰든 Haiku를 쓰든 변하지 않습니다. LangChain이 보여줬듯이 모델을 바꾸지 않고도 검증 구조만으로 25계단을 올렸고, 더 좋은 모델이 나와도 이 습관의 가치는 줄어들지 않습니다. 오히려 에이전트가 똑똑해질수록 검증의 중요성은 커집니다. 더 그럴싸한 실수를 하니까요.
마지막으로, 제 생각에 AI를 제일 잘 쓰는 방법은, AI에게 계속 물어보는 겁니다. 어떻게 하면 내가 널 더 잘 쓸 수 있어?라고요. 저는 주기적으로 세션 기록을 모아서 “내가 반복하는 실수 패턴이 보여?”라고 물어보기도 하고, insight 스킬로 작업 흐름의 개선점을 찾기도합니다. AI가 내 코드를 짜주는 것도 큰 가치이지만, AI가 나를 관찰하고 피드백해주는 것도 큰 가치입니다. 결국 AI와 함께 자기 발전을 하는 것 — 그게 이 도구를 가장 잘 쓰는 법이라고 생각합니다.
참고 자료
- OpenAI — Harness engineering: leveraging Codex in an agent-first world, 2026.2
- Anthropic — Harness design for long-running application development, 2026.3
- LangChain — Improving Deep Agents with Harness Engineering, 2026.2
- AgentField — Beyond Vibe Coding: How We Ship with 200 Autonomous Agents, 2026.3
- Martin Fowler — Humans and Agents in Software Engineering Loops, 2026
- Martin Fowler — Context Engineering for Coding Agents, 2026
- tw93 — Building a Stable Claude Code Collaboration System, 2026.3
- The New Stack — Vibe Coding Is Passé (Karpathy), 2026.2
- Anthropic — How AI assistance impacts the formation of coding skills, 2026.1 (논문)
- Sharma et al. — Towards Understanding Sycophancy in Language Models (ICLR 2024)
- ETH Zurich — Do AI Coding Agents Benefit from AGENTS.md Files?, 2026
- Anthropic — The Impact of AI on Developer Skill Acquisition, 2026.1
- Affaan Mustafa — Everything Claude Code (커뮤니티 리소스)
- Claude Code — Prompt cache regression #34629
- Boris Cherny — Claude Code Team Tips, 2026.2