단일 모델의 맹점을 넘어서:
3개 모델 견제 기반 AI 워크플로우 구축기
임주영
l 단일 모델의 맹점을 넘어서: 3개 모델 견제 기반 AI 워크플로우 구축기💡
올해 초, 저희 팀은 AI 코딩 에이전트를 프로덕션 워크플로우에 전면 도입했습니다. 코드 생성부터 PR 생성까지 자동화하며 생산성은 비약적으로 상승했습니다. 하지만 기쁨도 잠시, 생산성 뒤에 가려진 ‘구조적 결함’이 고개를 들기 시작했습니다.
1. LLM의 확률적 한계: ‘확신에 찬 오류’
LLM은 본질적으로 확률 모델입니다. 컨텍스트 내에서 가장 그럴듯한 다음 토큰을 예측하죠.
문제는 특정 모델이 가진 확률 분포 안에서는 틀리는 방향조차 일관되다는 점입니다.
예를 들어, 특정 모델이 분모가 0이 되는 상황을 방어하기 위해 max(denominator, 1)을 “안전한 패턴”으로 학습했다면, 통계 지표 산출 로직에서도 기계적으로 이 패턴을 적용합니다. 이는 지표의 정합성을 완전히 깨뜨리는 심각한 오류지만, 해당 모델은 이를 ‘최선의 해결책’이라 믿고 반복합니다.
더 큰 문제는 셀프 검증의 한계입니다. 동일한 확률 분포에서 샘플링을 반복하는 한, 모델은 자신의 맹점을 스스로 찾아내지 못합니다. “가끔 다른 모델에게 물어보는 수준”을 넘어, 서로 다른 분포를 가진 모델들이 서로를 견제하게 만드는 구조적 강제성이 필요해진 시점이었습니다.
AI 와 인간이 아닌 AI끼리 고군분투 하도록 설계한다
2. ‘견제와 균형’을 위한 멀티모델 아키텍처
우리는 서로 다른 아키텍처와 학습 데이터셋을 가진 세 가지 모델을 파이프라인에 배치했습니다.
모델별 역할 분리 (Role Separation)
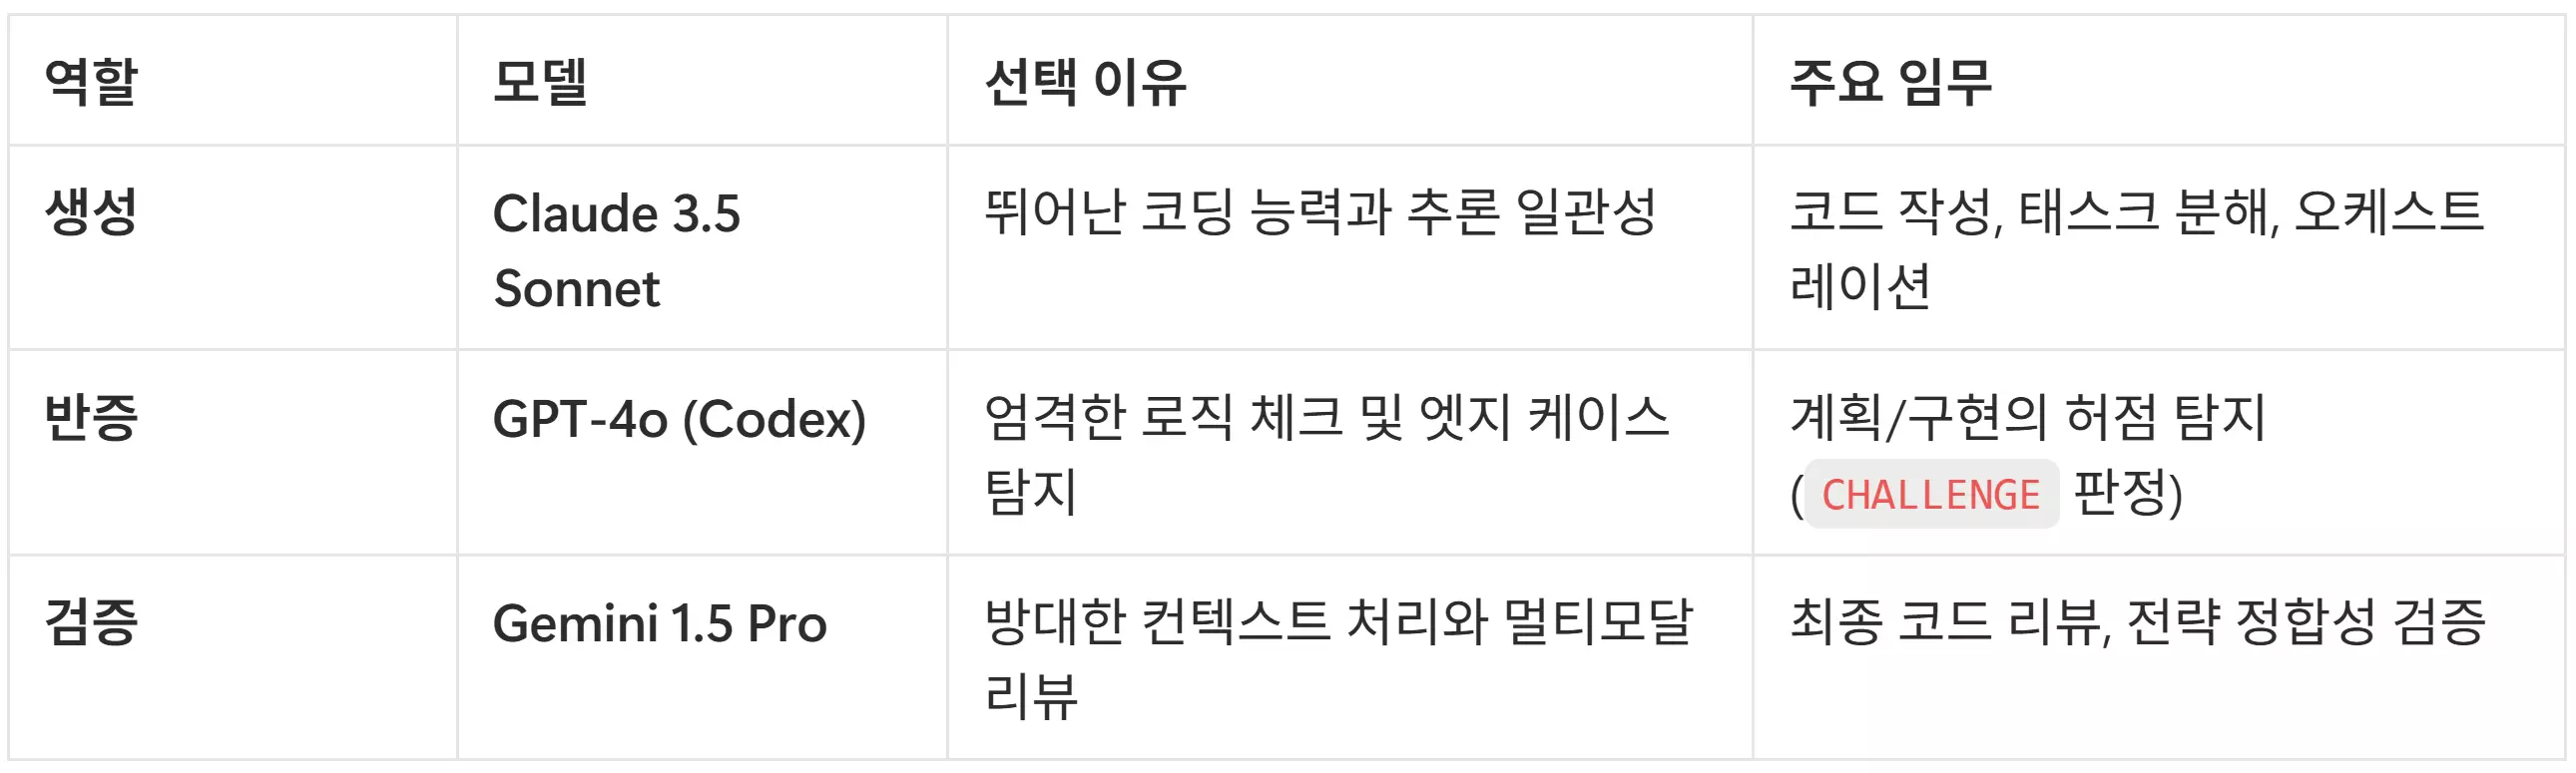
핵심은 ‘독립된 확률 분포의 충돌’입니다. 세 모델이 동시에 같은 방향으로 틀릴 확률은 단일 모델의 오류율보다 현저히 낮습니다.
3. 구현 디테일: 16단계의 선언적 파이프라인
단순히 순차적으로 실행하는 것이 아니라, 각 단계를 상태 머신(State Machine)으로 정의했습니다.
Pipeline Stage
리서치 → PRD 초안 → PRD 견제 → 리뷰 → 확정 → 태스크 분해 → 자기 점검 → 계획 견제 → 구현 → 구현 견제 → 리뷰 → 일관성 검증 → CTO 디브리프 → PR
- YAML 기반 오케스트레이션: 각 스테이지의 담당 모델, 판정 로직, 전이 조건(Transition)을 YAML로 관리합니다.
- BLOCK 시스템: 반증 모델이
BLOCK판정을 내리면 파이프라인은 즉시 중단됩니다. 이 장벽을 넘지 못하면 코드는 절대 PR 단계에 도달할 수 없습니다.
Why not LangGraph?
초기에는 LangGraph 도입을 검토했으나, CLI 환경에서의 세 벤더 모델 통합 제어와 저희만의 독자적인 세션 관리 로직을 태우기에는 오버헤드가 크다고 판단했습니다. 결국 필요한 추상화 수준에 맞춰 직접 오케스트레이터 레이어를 구현했습니다.
안전장치: 18개의 셸 스크립트 Hook
AI가 도구(Tool)를 호출할 때 발생할 수 있는 파괴적 행위를 막기 위해 Sandboxed Shell Hooks를 구축했습니다.
- 읽기 전용 레포지토리에 대한 Write 시도 차단
- DB 마이그레이션 등 위험 명령 실행 전 인간 승인 강제
- 크로스 레포지토리 작업 시 영향 범위 자동 탐지
컨텍스트와 ADR(Architecture Decision Record)에 기반하여 AI가 데이터를 자동 선별하는 Obsidian Vault 시스템을 도입해 AI가 실무에서 더 똑똑한 결정을 할 수 있게 한다
4. 컨텍스트의 중심, Obsidian과 ADR
AI가 똑똑해지려면 ‘현재 상태’와 ‘과거의 결정’을 정확히 알아야 합니다. 저희는 모든 프로젝트의 부산물을 Obsidian Vault에 축적합니다.
- ADR (Architecture Decision Record): “왜 이 통계 지표에서 NULL 처리를 선택했는가?” 같은 의사결정 맥락을 기록합니다.
- Dynamic Prefetching: AI 에이전트는 세션 시작 시 Obsidian 인덱스를 읽고, 관련 문서와 이전 결정 사항을 자동으로 프리페치하여 컨텍스트에 로드합니다.
이를 통해 AI는 단순한 코드 작성자가 아니라, 팀의 히스토리를 이해하는 파트너로 기능하게 됩니다.
5. 두 달간의 운영 결과: 무엇이 달라졌나
지표로 본 변화
- 버그 발견 시점의 전진: 단일 모델 사용 시 QA 단계에서 발견되던 논리 오류(예: 통계 분모 부풀리기)의 85%가 ‘구현 견제’ 스테이지에서 사전에 차단되었습니다.
- 크로스 레포 정합성: 6개 이상의 레포지토리가 얽힌 복잡한 수정 사항에서 인터페이스 불일치 실수가 거의 0에 수렴했습니다.
- 모든 자동화 과정, 인간의 판단은 그 어느때보다 중요 해졌다
얻은 교훈: 자동화할수록 선명해지는 ‘인간의 영역’
역설적이게도 자동화 수준을 높일수록 인간의 판단이 개입해야 하는 지점은 더 날카롭게 드러났습니다.
어떤 아키텍처가 장기적으로 유리한지, 비즈니스 요구사항과 기술적 부채 사이에서 어떤 트레이드오프를 선택할지는 AI가 결정해주지 않습니다. AI는 “가장 확률 높은 답”을 줄 뿐, “우리의 비전에 맞는 답”을 주지는 않기 때문입니다.
마치며: 진짜 문제는 ‘컨텍스트’에 있다
우리는 이제 기술적,사업적 의사결정을 내릴 때마다 “이 결정을 어떻게 데이터화해서 AI의 다음 컨텍스트에 전달할 것인가”를 고민합니다.
AI 워크플로우의 품질은 모델의 파라미터 수나 파이프라인의 화려함이 아니라, 인간의 판단이 얼마나 정확한 기록(ADR)으로 남고, 그것이 적시에 AI의 컨텍스트로 주입되느냐에 달려 있습니다.
자동화가 처리하는 영역이 넓어질수록, 남겨진 인간의 결정 한 건 한 건의 무게는 더욱 커집니다.
저희 팀은 이 무게를 견디며 제품의 영향력을 더 빠르게 넓혀가려 합니다.
함께 읽어보면 좋은 글
- [AI 에이전트 도입을 위한 아키텍처 결정 기록(ADR) 작성법]
- [LLM의 Hallucination을 역이용해 버그를 찾는 법]